
AI Gateway - KI-Kostenkontrolle für Coding-Agenten, Tools und Abos
Das innFactory AI Gateway ist die zentrale Governance- und FinOps-Schicht für Künstliche Intelligenz: eine API für alle Provider, Budgets für Kostenstellen, Nutzer und Keys, und ein Companion, der die Agent-Zeit von Claude Code, Codex und OpenCode misst - auch wenn die Tools über ein Abo laufen. DSGVO-konform, betrieben in Ihrer Cloud, entwickelt in Deutschland.
Jetzt verfügbar: seit August 2026 bei ersten Kunden produktiv (Version 1.0) | Eigenständig oder integriert in CompanyGPT | Alle Preise zzgl. 19 % USt.
Was ist das AI Gateway?
Entwicklungsteams und KI-Agenten nutzen heute viele Provider parallel - jeder mit eigenem Key, eigener Abrechnung und eigenem Tracking. Dazu kommen Coding-Agenten im Abo, deren Arbeit in keiner Rechnung auftaucht. Das Ergebnis: zersplitterte Kosten, Budgetüberschreitungen und keine Governance. Das innFactory AI Gateway sitzt als zentraler Proxy zwischen Ihren Tools und allen KI-Providern und misst mit dem Companion, was daneben passiert. Eine URL, ein Key, volle Kontrolle - und jeder Token wird transparent zugeordnet.
Das Problem: KI-Wildwuchs in größeren Unternehmen
Je mehr Teams, Tools und Agenten KI nutzen, desto schneller verlieren Sie Überblick, Kontrolle und Budget.
Schlüssel-Wildwuchs & Schatten-KI
API-Keys liegen verstreut in .env-Dateien, Skripten und CI-Pipelines. Niemand weiß, wer welchen Provider nutzt - und jeder geleakte Key ist ein Sicherheits- und Kostenrisiko.
Kosten ohne Zuordnung
Am Monatsende kommt eine Sammelrechnung von OpenAI, Anthropic & Google. Welches Team, welches Projekt, welcher Kunde sie verursacht hat? Niemand kann es sauber beantworten.
Keine Governance, Compliance-Risiko
Welche Modelle darf wer nutzen? Wird die DSGVO eingehalten? Gibt es ein Audit-Log? Ohne zentrale Schicht bleibt das offen - ein echtes Risiko nach EU AI Act.
Agenten im Abo bleiben unsichtbar
Coding-Agenten arbeiten stundenlang an Repositories, oft über ein Abo, das nie durch eine API-Rechnung läuft. Ohne Messung wissen Sie weder, welches Projekt die Zeit verbraucht, noch was sie zum Listenpreis wert wäre.
Genau dafür gibt es das AI Gateway - eine zentrale Schicht, durch die jeder KI-Zugriff läuft, und ein Companion, der misst, was daneben passiert.
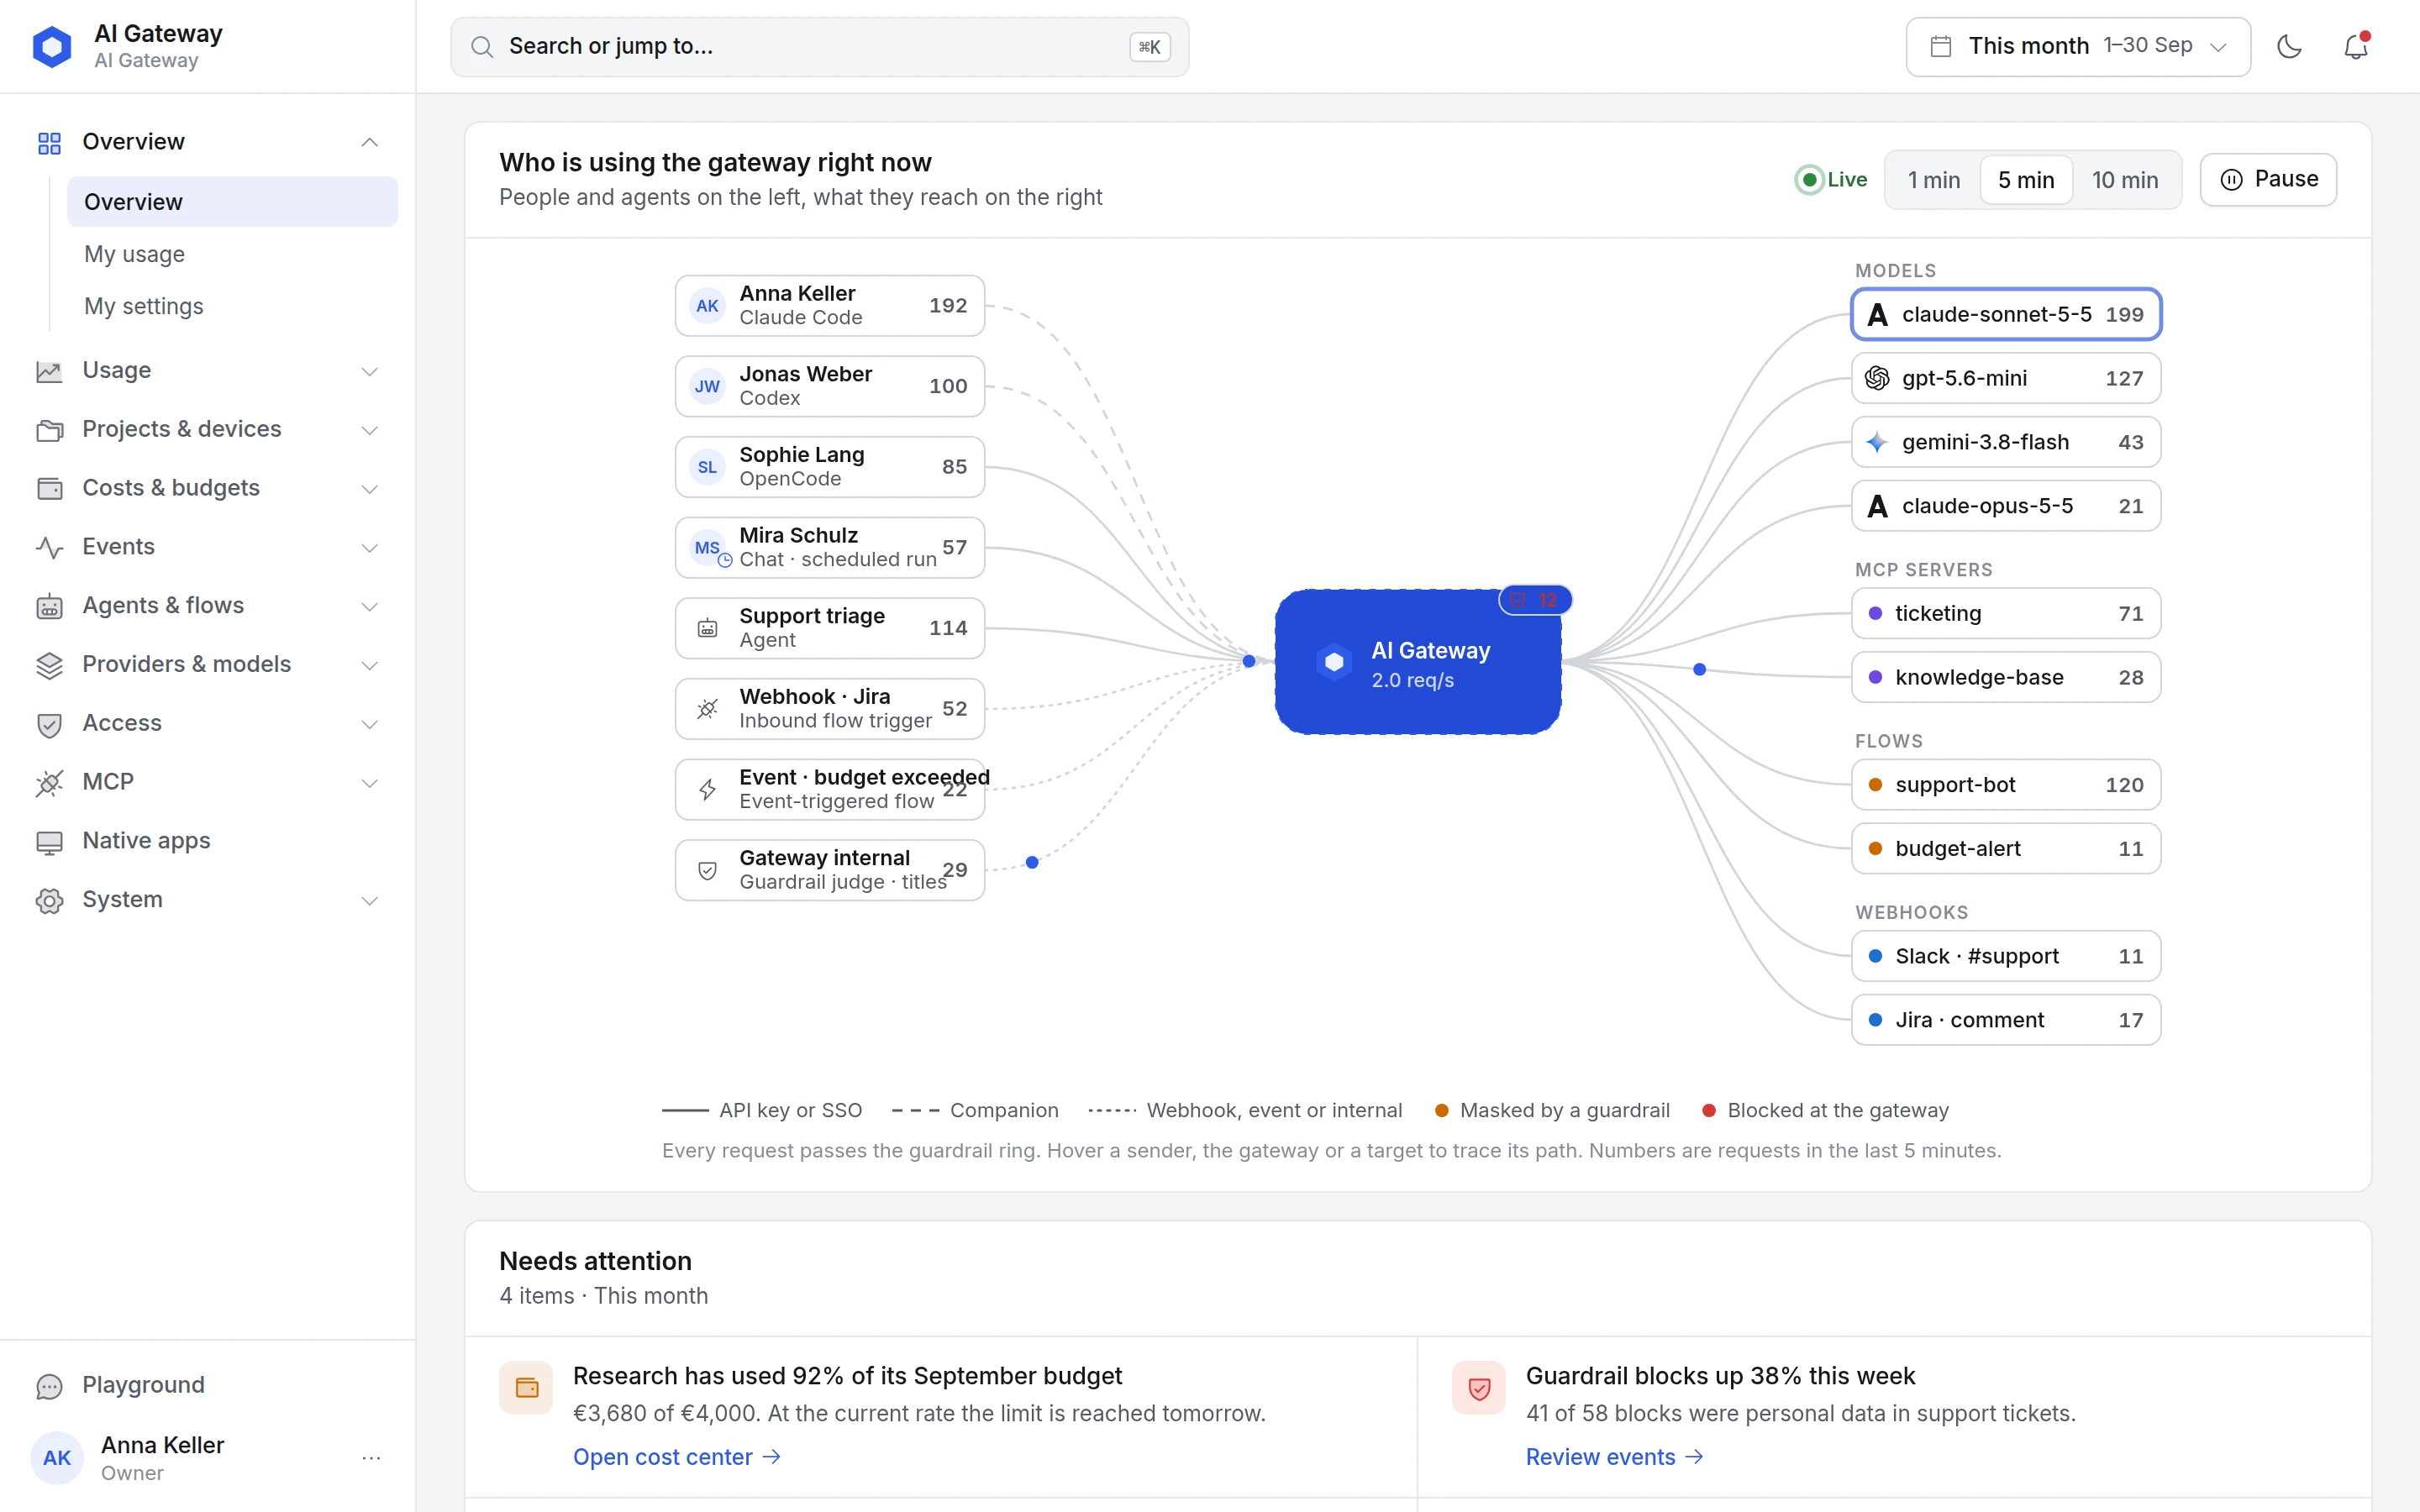
So fließen Ihre Daten durch das Gateway
Das Gateway ist Ihre zentrale Enterprise-Security- und Governance-Schicht für KI: Nutzer, Agenten und Coding-Tools sprechen eine OpenAI-kompatible API. Das Gateway authentifiziert, budgetiert, prüft per Guardrails, protokolliert — und routet zum passenden Modell.
Warum ein eigenes AI Gateway?
Kostenkontrolle, Governance und Geschwindigkeit - ohne Vendor-Lock-in
AI-FinOps
Jeder Request wird erfasst, bewertet und einer Kostenstelle zugeordnet. Endlich wissen Sie, welches Team, welcher Nutzer, welches Repository und welcher Agent welche KI-Kosten verursacht - in Euro, nach dem EZB-Tageskurs.
Budgets, die wirklich stoppen
Limits für Organisation, Kostenstelle, Nutzer und API-Key greifen unabhängig voneinander. Ist eines erschöpft, antwortet das Gateway mit 402 oder routet auf ein günstigeres Fallback-Modell - Sie entscheiden.
Multi-Provider, drei Dialekte
Dreizehn Provider-Typen hinter einer API im OpenAI-, Anthropic- oder Gemini-Dialekt - inklusive Vertex AI im EU-Endpunkt. Modelle wechseln per Alias, ohne dass Ihre Tools oder Agenten umkonfiguriert werden müssen.
Enterprise-Security-Schicht
Policy-basierte Guardrails prüfen Anfragen und Antworten, Rollen und Rechte kommen aus Microsoft Entra ID oder Keycloak, Provider-Zugangsdaten liegen AES-256-GCM-verschlüsselt mit rotierbaren Schlüsseln, und jede Aktivität landet im Audit-Log.
Souverän & DSGVO-konform
Betrieb in Ihrer Cloud oder in deutschen, souveränen Rechenzentren (STACKIT) mit PostgreSQL. Ihre Prompts und Daten bleiben unter Ihrer Kontrolle - EU AI Act inklusive.
Schlank und schnell im Betrieb
Das Gateway ist ein einzelnes Binary im Container, ohne Laufzeitumgebung. Budget- und Rate-Limit-Prüfungen laufen im Arbeitsspeicher statt in der Datenbank, der Proxy-Pfad bleibt schlank: Ihre Tools und Agenten spüren das Gateway nicht.
Zwei Betriebsarten: Proxy-Modus und Companion-Modus
Das Gateway kontrolliert, was durch es hindurchläuft. Der Companion misst, was Coding-Agenten daneben leisten - auch im Abo.
Jede Anfrage läuft durch das Gateway
Tools und Agenten sprechen das Gateway in ihrem gewohnten Dialekt an: OpenAI (Chat Completions, Responses), Anthropic (Messages) oder Gemini. Das Gateway prüft Budget, Rechte und Guardrails, wählt Provider und Modell, rechnet jeden Token ab und schreibt das Audit-Log.
- Fertige Setups für Claude Code, Codex, OpenCode, Cowork, VS Code Continue und GitHub Copilot
- Kurzlebige Proxy-Tokens pro Gerät statt statischer Keys in Config-Dateien
- Claude wahlweise über AWS Bedrock oder Google Vertex AI - inklusive Prompt-Caching und Thinking
- Modell-Discovery für Claude Code: das Gateway liefert die freigegebenen Modelle in die Auswahl des Tools
Agent-Zeit messen, auch im Abo
Der Companion aigw ist ein kleiner Hintergrunddienst auf dem Rechner der Entwicklerin oder des Entwicklers. Er liest die lokalen Sitzungsprotokolle von Claude Code, Codex und OpenCode und meldet Agent-Zeit, LLM-Zeit und Token-Klassen ans Gateway - auch dann, wenn das Tool über ein Abo läuft und nie eine Gateway-Anfrage stellt.
- Agent-Zeit (aktive Arbeitszeit des Agenten) und LLM-Zeit (Dauer der Modellaufrufe) getrennt ausgewiesen
- Companion-Tokens aus Abos zum Listenpreis bewertet, nie abgerechnet oder budgetiert
- Projekte und Repositories mit Kostenstellen-Regeln nach Repository, Organisation oder Host
- Datensparsam: feste Allow-List, keine Prompts, keine absoluten Pfade, keine Zugangsdaten in Remote-URLs -
aigw doctor --show-payloadzeigt jede Übertragung - Rollout: Gerätecode-Login, Enrollment-Token für Intune und MDM, Tray-App für macOS und Windows
Companion-Tokens stammen aus Abo-Sitzungen, die nie über das Gateway liefen. Sie werden zum Listenpreis bewertet (≈), aber nie abgerechnet oder budgetiert.
Beide Modi in einem Befehl
aigw run startet Claude Code, Codex oder OpenCode mit einem kurzlebigen Proxy-Token des aktuellen Kontexts. Die eigene Konfiguration des Tools bleibt unangetastet: Claude Code bekommt eine temporäre Settings-Datei, Codex ein eigenes Profil, OpenCode seine Konfiguration über die Umgebung. Gleichzeitig läuft die Messung der Agent-Zeit.
aigw login --base-url https://gateway.example.com
aigw daemon install
aigw setup apply <setup-id>
aigw run claude --setup <setup-id>
aigw run codex
aigw run opencode
Ein Gateway vor allen Coding-Tools und Agent-Harnesses
Hängen Sie Agent-Harnesses wie Claude Code, Codex und OpenCode hinter das Gateway - zentral kontrolliert, budgetiert und einer Kostenstelle zugeordnet. Fertige Setups werden vom Admin als Vorlage gepflegt und von jeder Entwicklerin und jedem Entwickler mit eigenem Key geklont.
Claude Code
Proxy + CompanionAnthropics Coding-Harness. Native Messages-API, Modell-Discovery, Rollen (main, background, opus, sonnet, haiku) auf Gateway-Modelle gemappt, Agent-Zeit per Companion.
Codex
Proxy + CompanionOpenAI Codex CLI über die Responses-API. Eigenes Gateway-Profil in der Codex-Konfiguration, Agent-Zeit per Companion.
OpenCode
Proxy + CompanionTerminal-Coding-Agent. Provider, Modelle und Agenten in einer generierten opencode.json, Agent-Zeit per Companion.
Cowork · Claude Desktop
ProxyVerwaltetes Profil für macOS und Windows setzt Gateway-Adresse und Auth-Schema. Claude Desktop zusätzlich als MCP-Client für die Konfiguration in natürlicher Sprache.
VS Code · Continue & Copilot
ProxyContinue.dev mit Chat-, Edit-, Apply- und Autocomplete-Rollen; GitHub Copilot mit eigenen Modellen (BYOK) und API-Typ je Modell.
Pi, Gemini CLI & weitere
OpenAI-kompatibelJeder Harness, der eine eigene Basis-URL im OpenAI-, Anthropic- oder Gemini-Dialekt akzeptiert, läuft über das Gateway - ohne fertiges Setup und ohne Agent-Zeit-Messung. Übersicht aller Harnesses.
Plus LibreChat und CompanyGPT über Trusted-Header-Auth, MCP-Server-Registry und der Grundlagenartikel AI Harness erklärt.
AI-FinOps: Kostenstellen, Budgets und Rollen
Token-FinOps in der Praxis: Ordnen Sie KI-Kosten dem zu, wo sie entstehen - bis auf den einzelnen Kunden, das einzelne Repository, die einzelne Person
POST /v1/chat/completions
Authorization: Bearer aig_••••••••
X-Cost-Center: (wählen und senden)
Jede Antwort trägt Budget-Header für Organisation, Kostenstelle, Mitglied und Key - Werte in Mikro-Dollar, die Anzeige im Dashboard in Euro. Ist ein Limit erschöpft, antwortet das Gateway mit 402 oder routet auf das hinterlegte Fallback-Modell; der Header nennt dann das Gate, das sonst abgelehnt hätte. Per-Member-Caps sind immer harte Stopps.
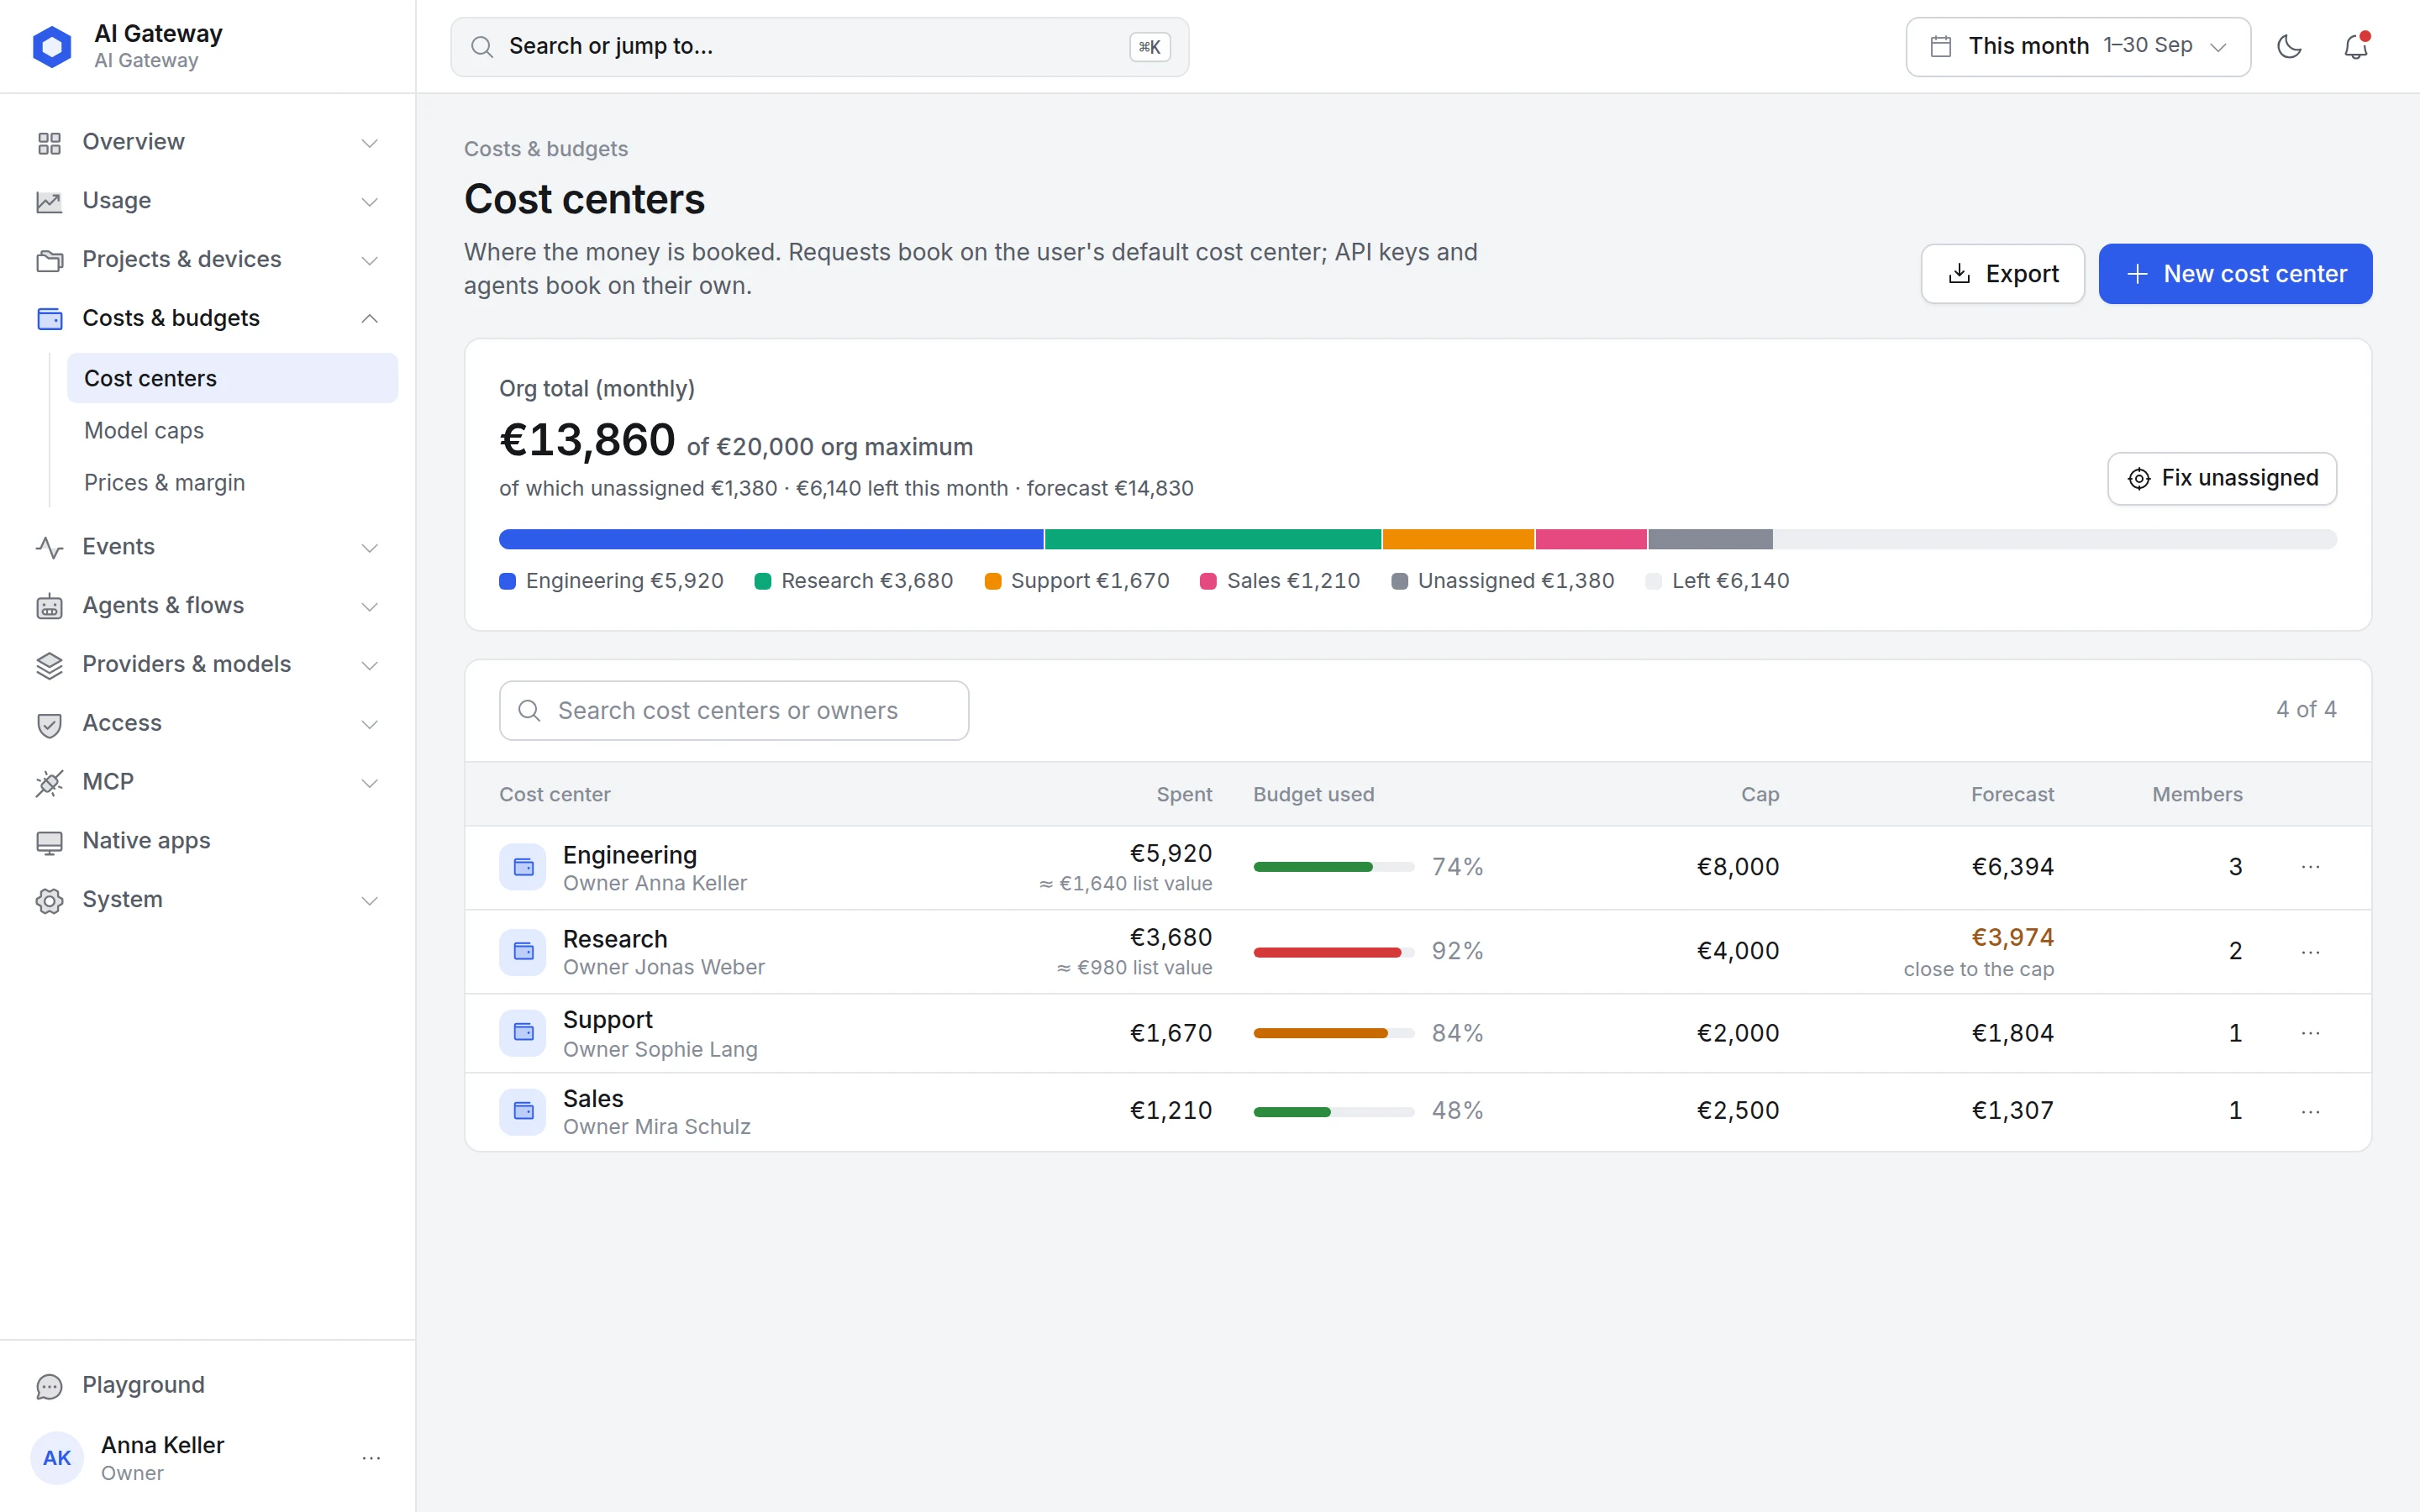
Kostenstellen: wo das Geld gebucht wird
Eine Seite zeigt, wie viel vom Organisationsbudget bereits verbraucht ist, wie es sich auf Abteilungen, Projekte und Kunden verteilt und was noch nicht zugeordnet ist. Jede Kostenstelle trägt Verbrauch, Auslastung, Cap, Monatsprognose und Mitglieder.
- Standard-Kostenstelle je Nutzer, eigene Buchung für API-Keys und Agenten
- Prognose zum Monatsende und Warnung, wenn ein Cap in Reichweite kommt
- Nicht zugeordnete Kosten auf einen Klick bereinigen
- Listenwert von Abo-Nutzung separat ausgewiesen, nie abgerechnet
Kostenstellen statt Bauchgefühl
Legen Sie Kostenstellen für Abteilungen, Projekte oder Kunden an - im Pool-Modus mit gemeinsamem Limit oder im Per-User-Modus mit Cap je Mitglied. Monats-, Wochen- und Tagesfenster, Per-Model-Caps und Sub-Limits stoppen weitere Nutzung automatisch.
Tool-Setups und Repository-Regeln
Entwickler klonen ein Tool-Setup mit eigenem Key, das direkt auf eine Kostenstelle bucht. Agent-Zeit aus dem Companion wird über Regeln nach Repository, Organisation oder Host zugeordnet - AI-FinOps ohne manuelle Zettelwirtschaft.
User-Scoping über Ihren Identity-Provider
Nutzer authentifizieren sich über Microsoft Entra ID, Keycloak oder einen anderen OIDC-Provider und werden granular gescopt: erlaubte Modelle, Budgets und Rate-Limits pro Person. Gastkonten außerhalb Ihrer Domains bekommen keinen Proxy-Zugriff.
Sieben Rollen für Finance, Audit und Security
Owner, Admin, Auditor, Finance, Security, Member und Gast sehen jeweils nur ihren Bereich: Finance die Kosten und Margen, Auditor alles lesend, Security die Guardrails und Ereignisse. Kostenstellen haben eigene Verwalter, Rollen kommen aus den Gruppen Ihres Identity-Providers.
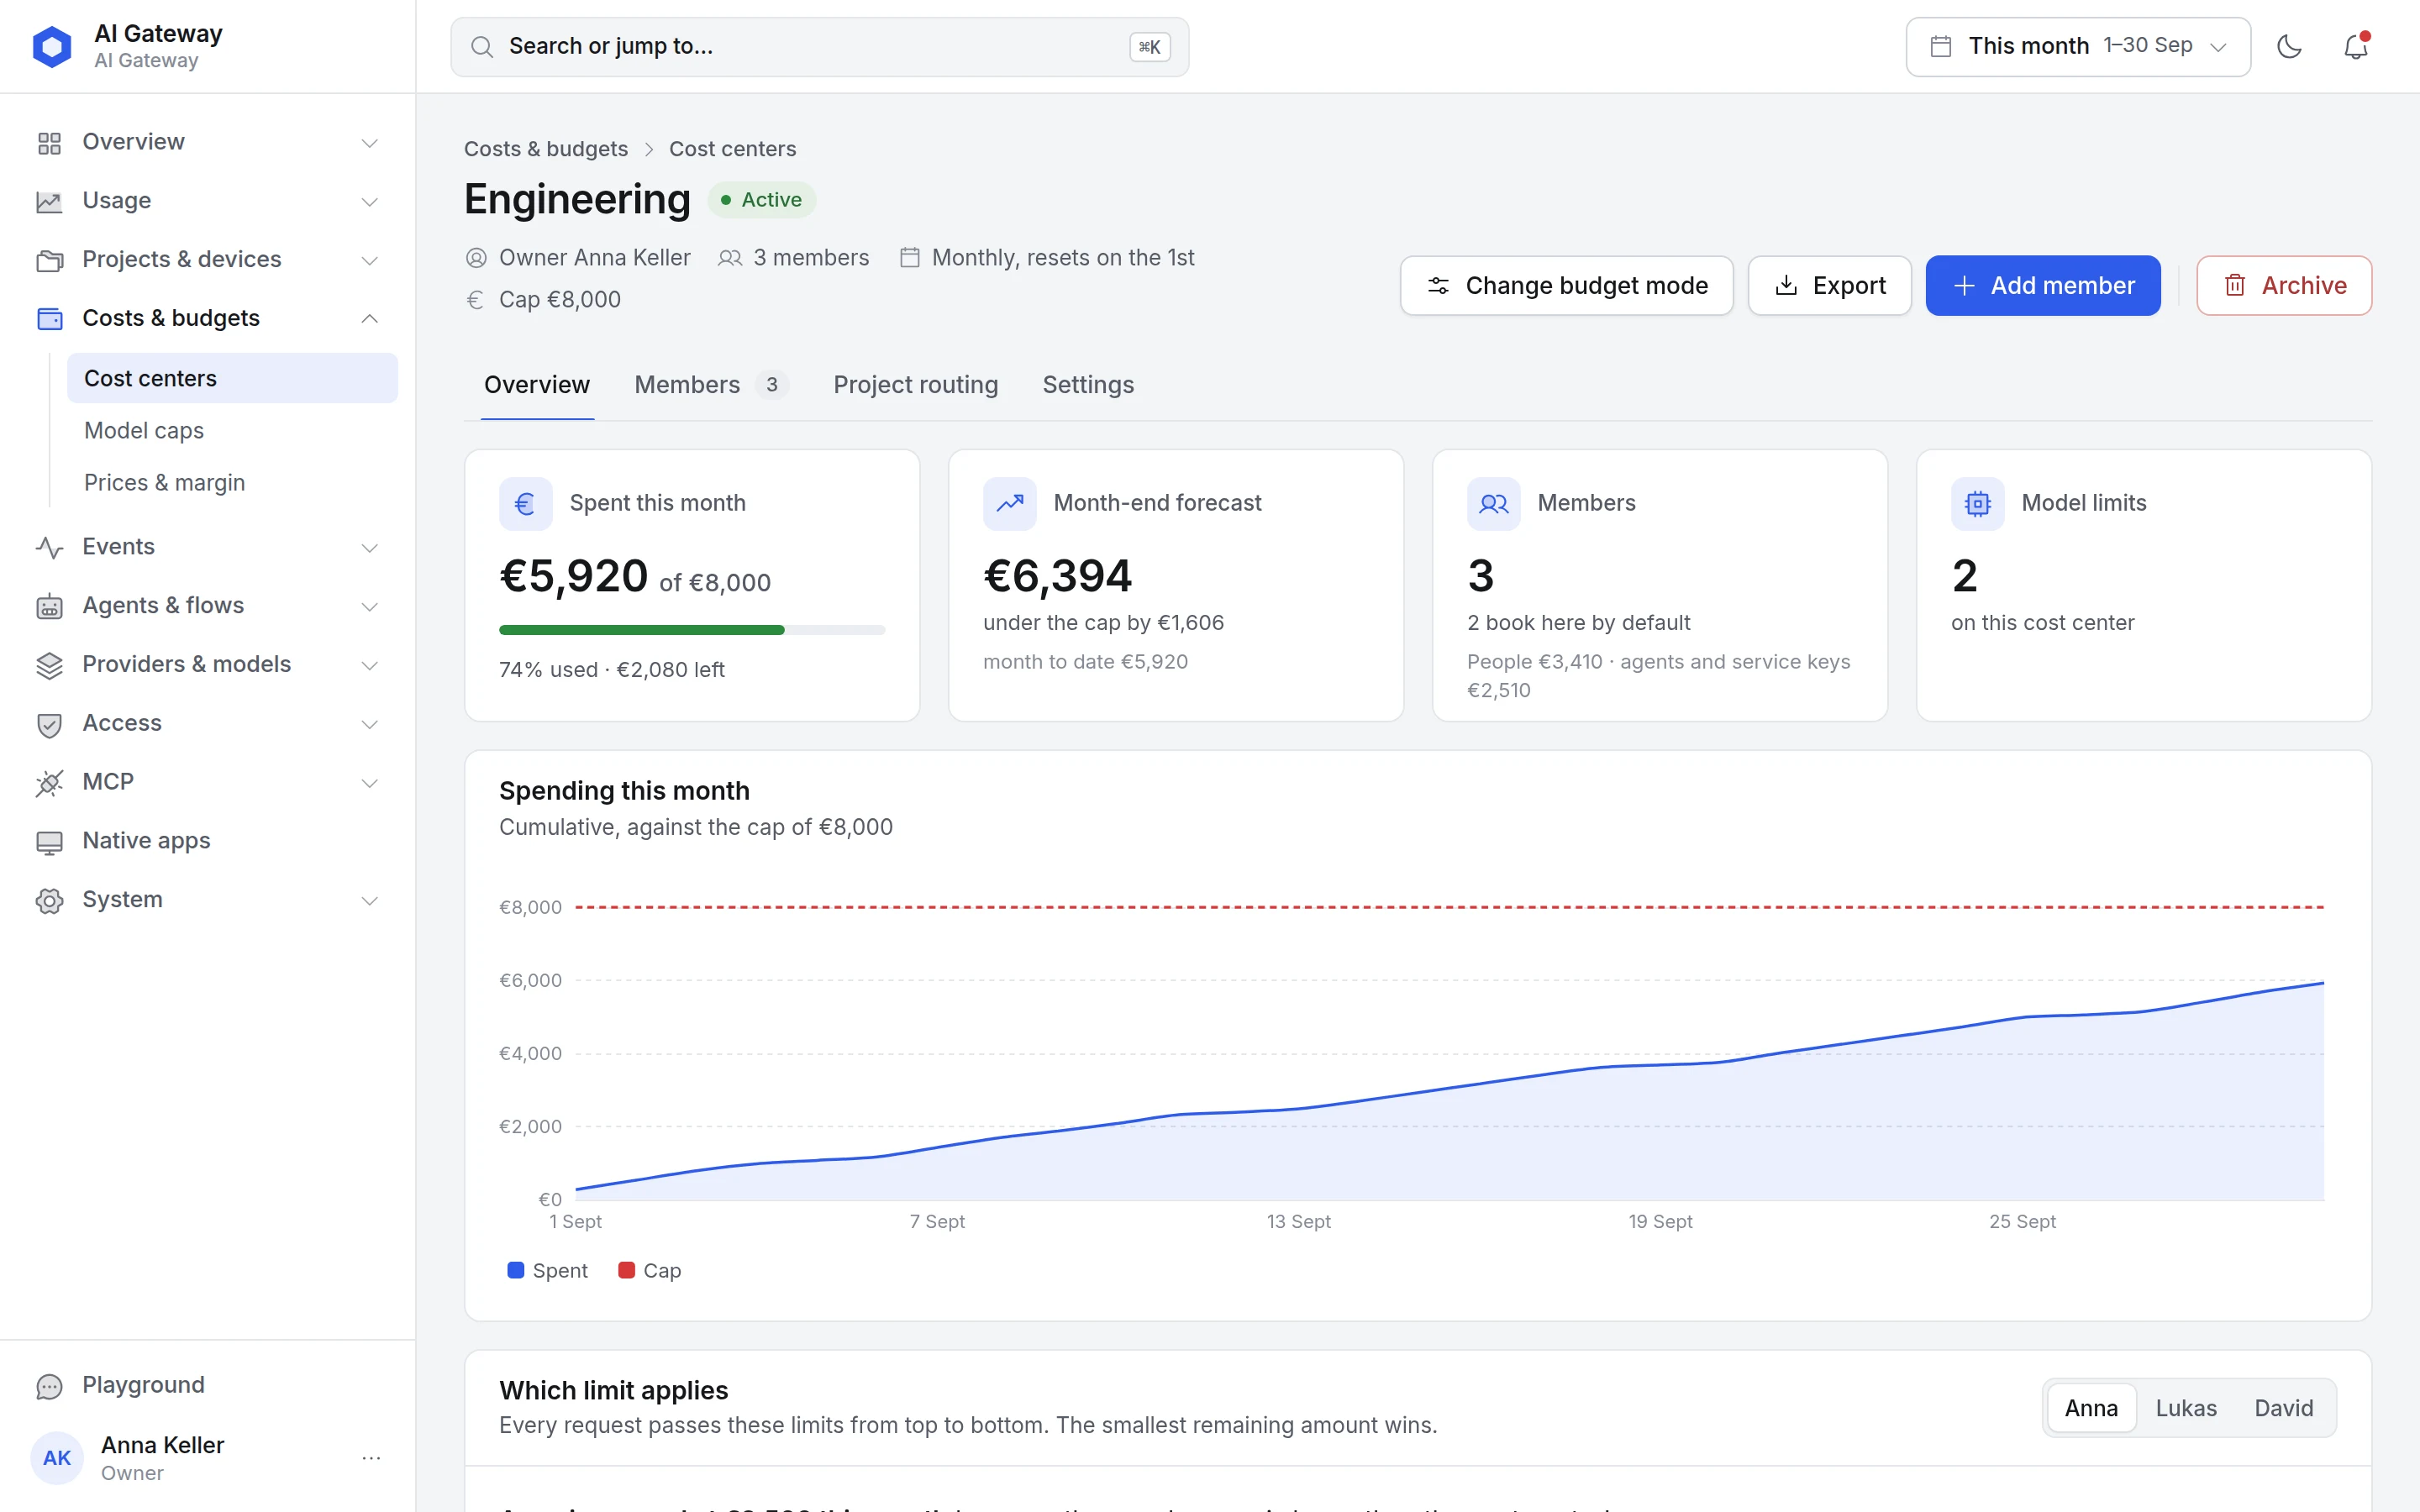
Budgets, die unabhängig voneinander greifen
Jedes Limit prüft für sich - das Gateway blockt oder routet um, bevor es teuer wird
Transparente Preise - in Euro, mit Freigabe
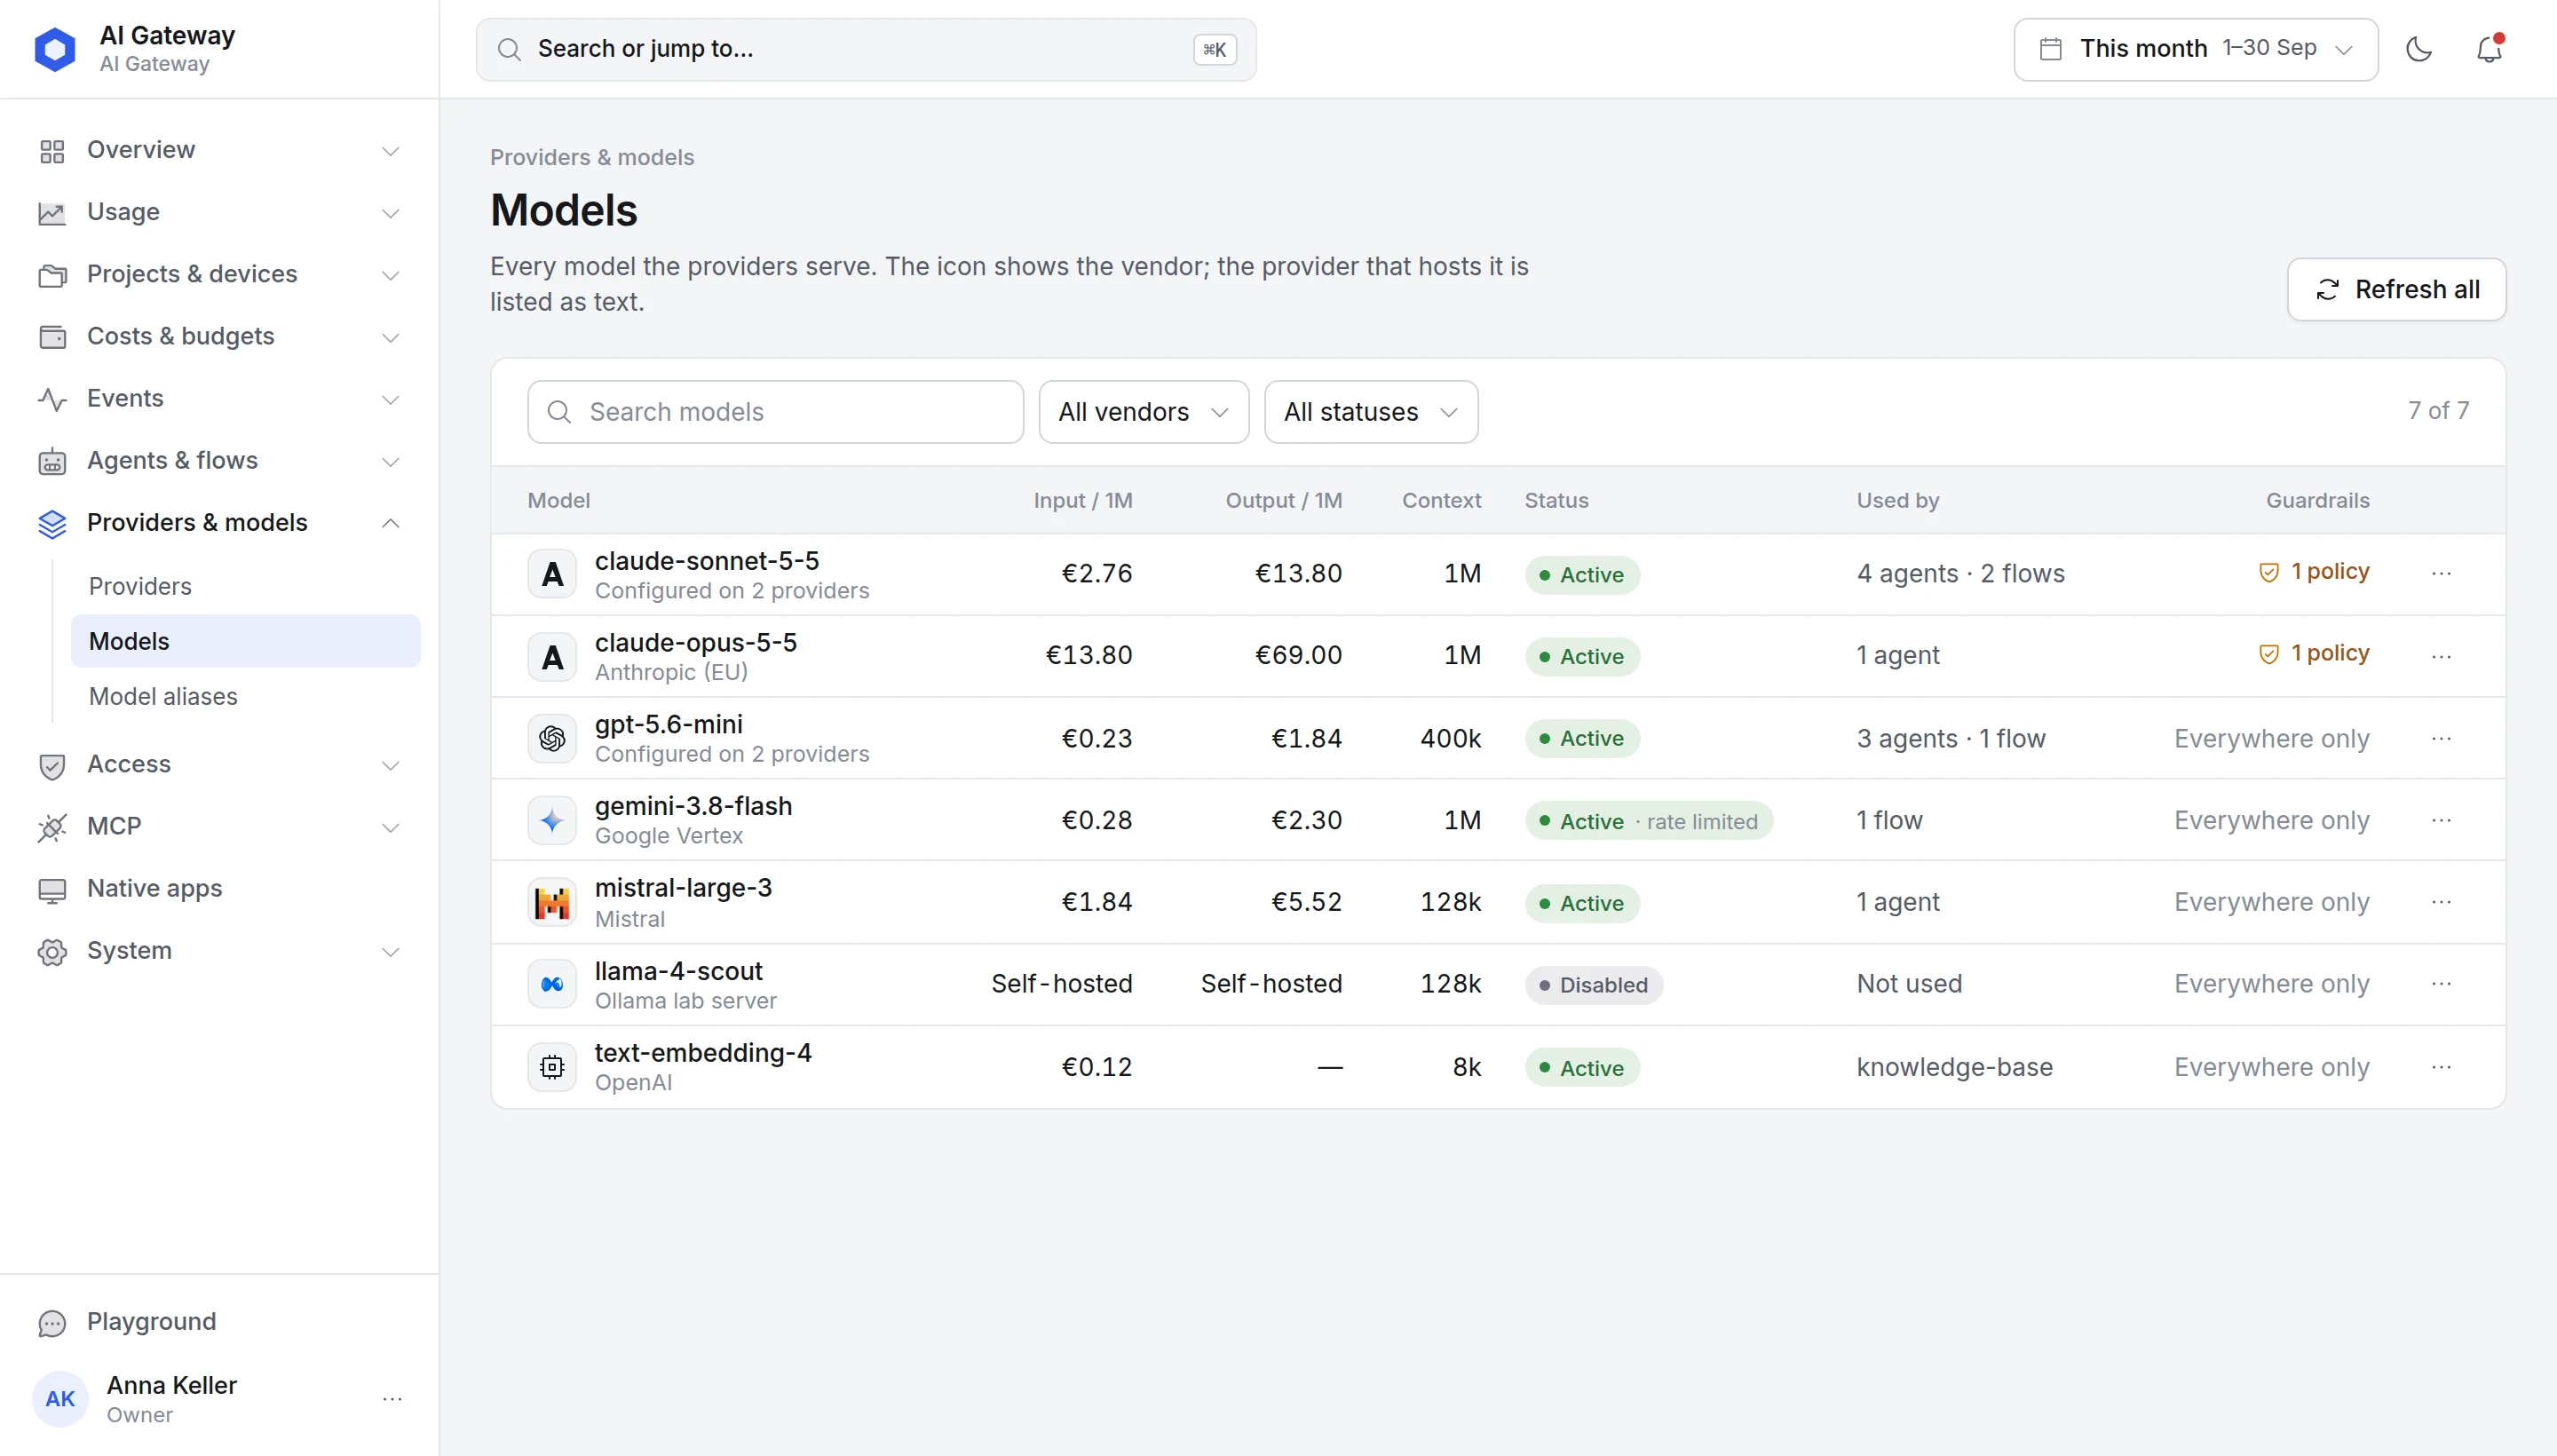
Modelle werden automatisch von Ihren Providern eingelesen. Die Token-Preise stammen aus unserem europäischen Preiskatalog ai-prices.eu, werden vor der Übernahme von einem Admin geprüft und lassen sich jederzeit individuell überschreiben.
- Input-, Cache- und Output-Preise pro Million Tokens - je Modell sichtbar
- Echte Kosten in Euro nach EZB-Tageskurs, intern in US-Dollar geführt
- Unbepreiste Modelle nach Ihrer Regel: erlauben, zum Mindestpreis abrechnen oder ablehnen
- Eigene Aufschläge und Kundenpreise mit Marge - für die Weiterberechnung
Flow Builder: Modelle, Guardrails und Webhooks verketten
Bauen Sie Abläufe direkt über dem Gateway - ohne zusätzliche Infrastruktur, mit denselben Kostenstellen und Budgets
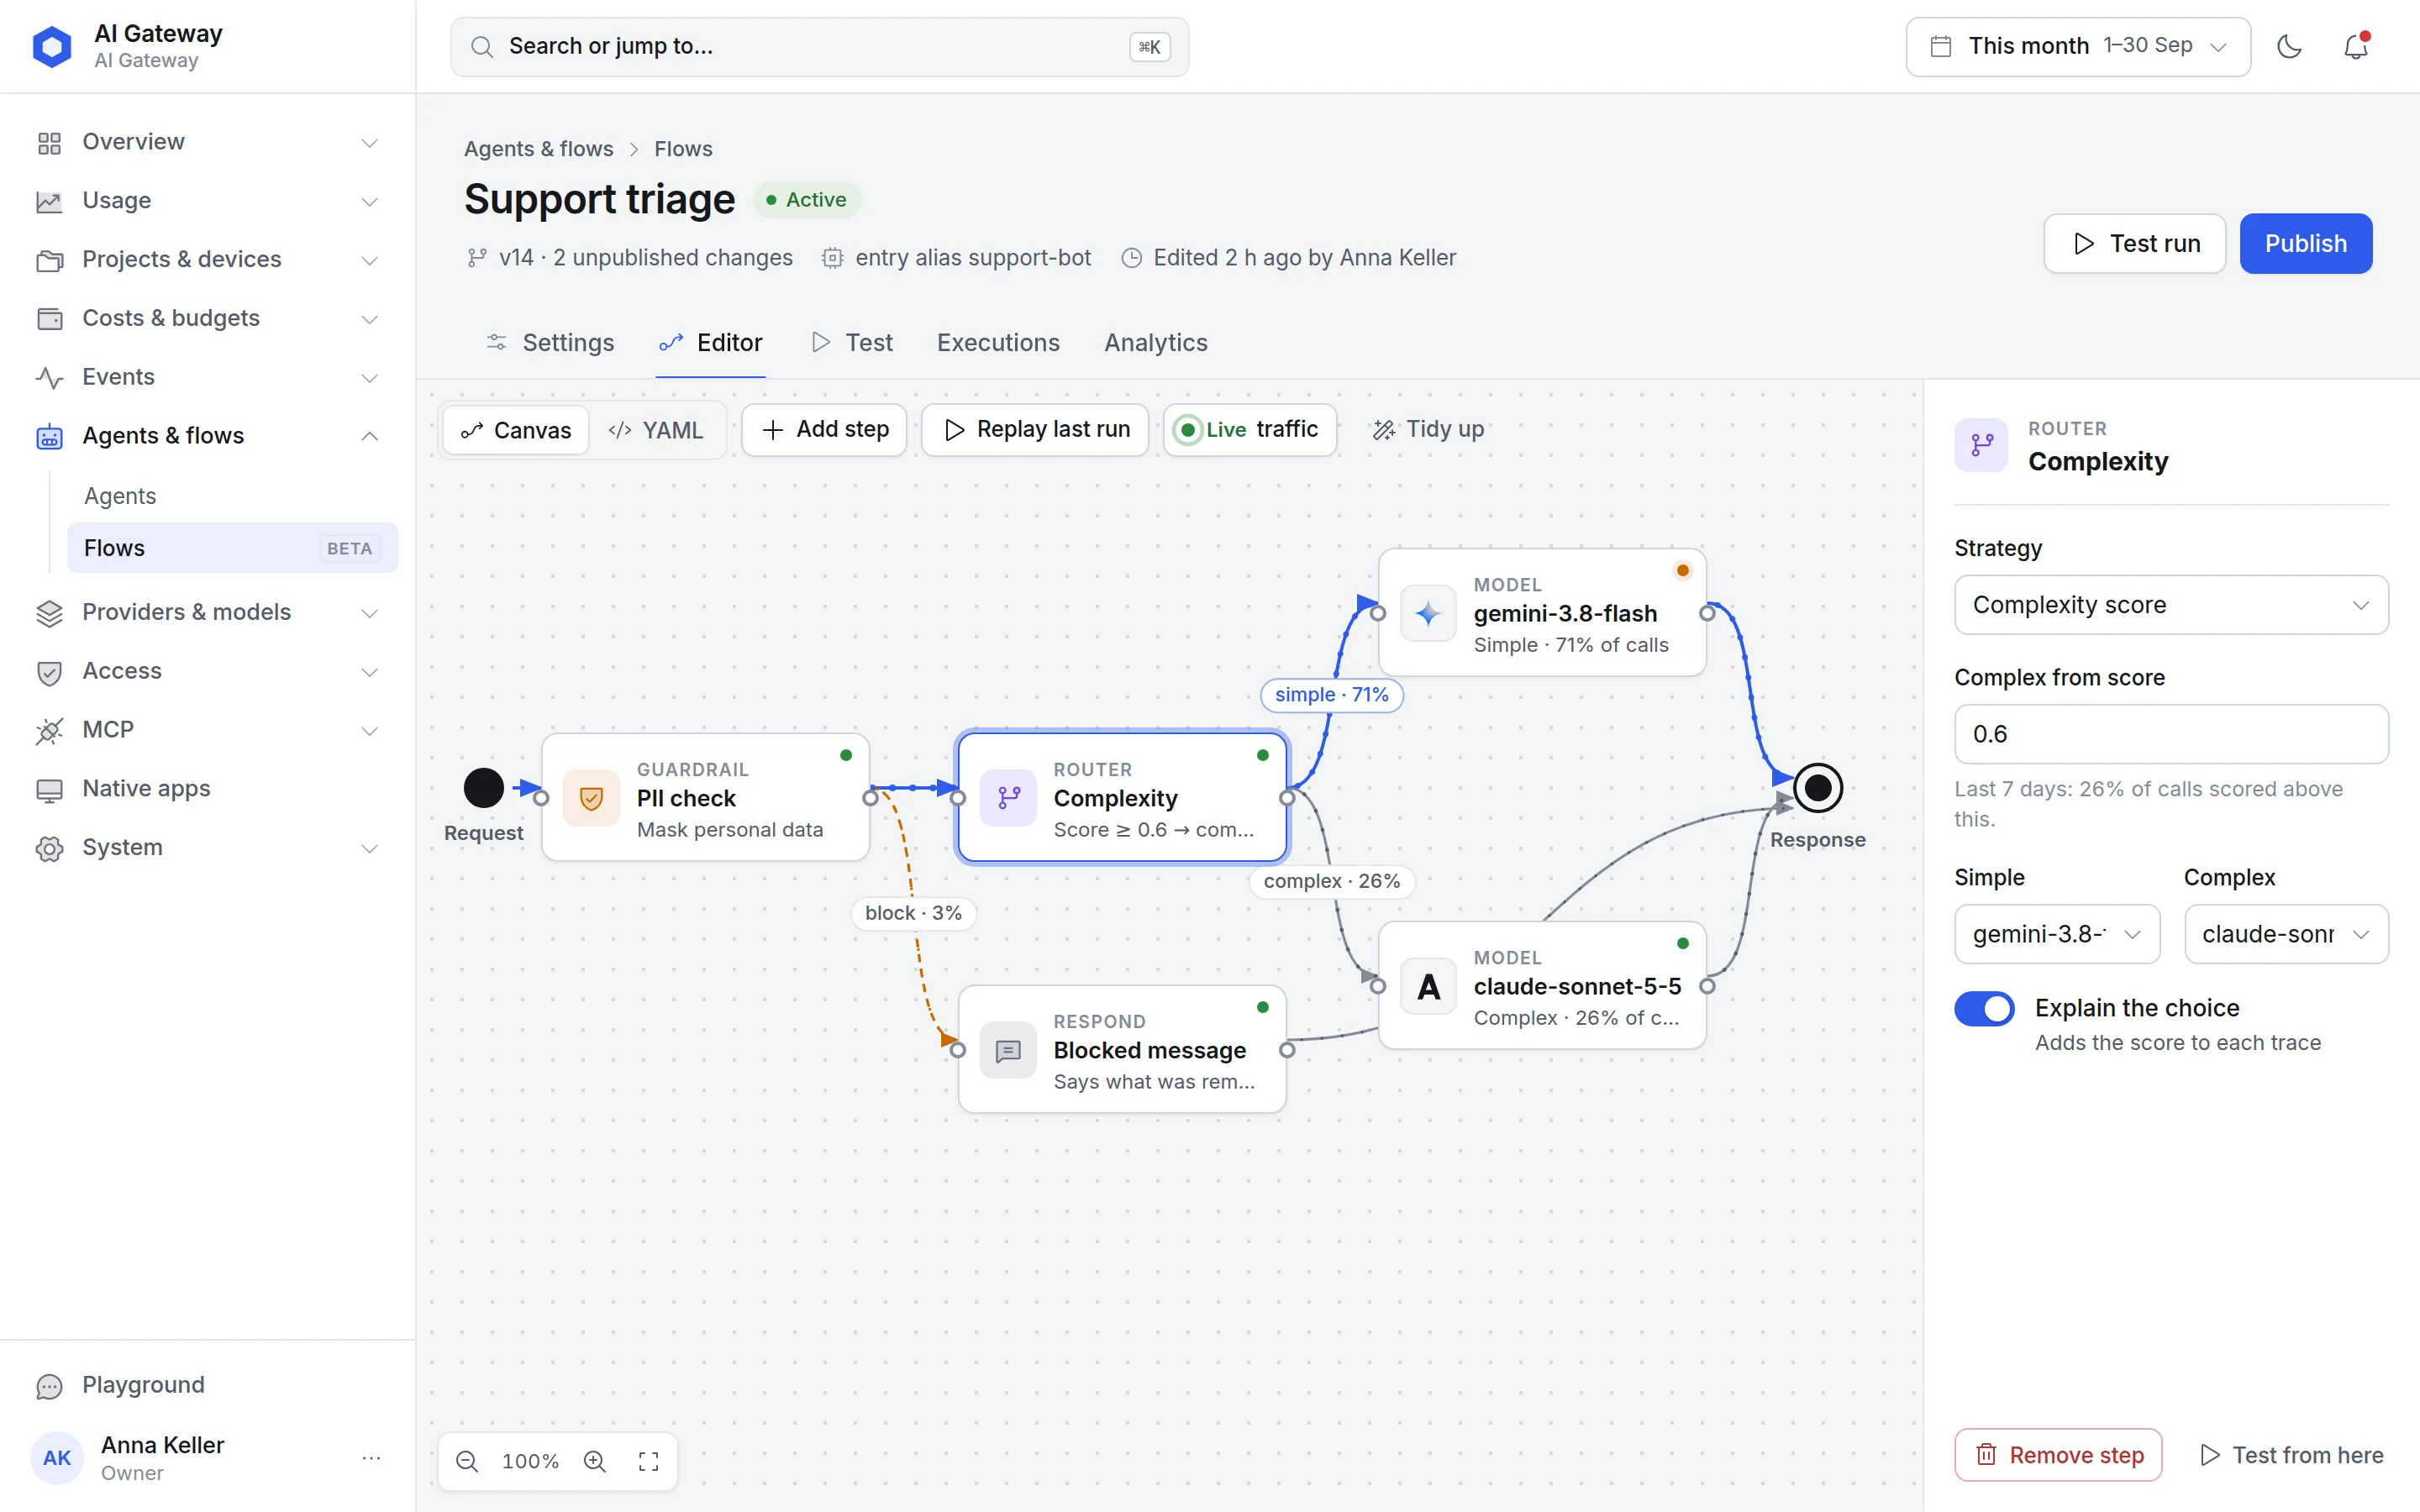
Der Editor im Gateway
Knoten auf der Leinwand, Einstellungen im Seitenpanel, Live-Anteile an jeder Kante: Der Editor zeigt, welcher Anteil der Anfragen über welchen Pfad läuft, und erklärt auf Wunsch jede Routing-Entscheidung im Trace.
- Leinwand oder YAML, Versionen mit unveröffentlichten Änderungen
- Testlauf und Replay des letzten Laufs direkt aus dem Editor
- Live-Traffic auf den Kanten, Ausführungen und Analytics je Flow
Neun Routing-Strategien
Failover, gewichtet, Least Cost, Least Latency, Capability Match, Komplexität, Cost Cascade, LLM-Entscheidung und Mandanten-Scope - je Knoten wählbar, mit Fallback über Provider hinweg.
Guardrails als Router
Ein Guardrail-Knoten prüft Inhalte und verzweigt nach Verdikt - freigeben, blocken oder Fehler - jeweils auf einen eigenen Pfad; Schwärzen passiert auf dem Freigabe-Pfad. Ereignis-Trigger wie ein überschrittenes Budget starten Flows und rufen Webhooks.
Wie ein Modell aufrufbar
Ein Flow bekommt einen Namen und wird von Tools wie jedes Modell angesprochen. Vorlagen, Trockenlauf, Undo, touch-fähige Leinwand auf Tablets und ein YAML-Editor auf dem Smartphone.
Mehr als ein LLM-Proxy
Das Gateway governt nicht nur Modell-Aufrufe, sondern auch Tool-Zugriffe, Sprache und seine eigene Konfiguration
MCP-Proxy mit Audit
MCP-Server Ihrer Agenten laufen durch dieselbe Schicht: acht Auth-Modi vom Client-Credentials-Flow bis zum OAuth-Login je Nutzer, benannte Toolsets als Zugriffsebene, Guardrails auf Tool-Argumente und -Ergebnisse. Jeder Tool-Aufruf wird auditierbar - wer hat wann welches Werkzeug genutzt.
Konfiguration in natürlicher Sprache
Der eingebaute MCP-Server gateway-config stellt 48 Werkzeuge bereit, mit denen Claude Desktop, Claude Code oder jeder MCP-Client das Gateway verwalten: Kostenstellen anlegen, Budgets setzen, Modelle freischalten. Destruktive Änderungen verlangen eine zweite Bestätigung.
Guardrails mit Schattenmodus
Neun Regeltypen - von Secret- und PII-Erkennung über Prompt-Injection bis zu Denied Topics und externen Prüfdiensten - schwärzen auch mitten im Stream. Neue Richtlinien laufen erst im Schattenmodus mit und blocken erst, wenn Sie es freigeben. Ein DSGVO-Preset ist eingebaut.
Neue Modelle ohne Client-Änderung
Die Adapter erkennen Modellfamilie und Version statt fester Listen und fangen modellspezifische API-Brüche ab - etwa die von Claude Fable 5.1 abgelehnte erzwungene Tool-Wahl oder das bei Gemini 3.7+ entfallene Thinking-Level minimal. Ihre Tools müssen dafür nichts ändern.
Auto-Router nach Prompt-Komplexität
Ein auto-Modell bewertet jeden Prompt und wählt die passende Stufe (einfach, mittel, komplex, Reasoning) - ausschließlich aus den Modellen, die der Nutzer laut Access Group verwenden darf. Dazu Aliase, Fallbacks über Provider hinweg, ein optionaler Response-Cache und auf gepufferten Antworten der Header x-aigateway-response-cost.
Realtime & Voice
OpenAI Realtime, Azure OpenAI, Gemini Live (auch über den Vertex-EU-Endpunkt) und ElevenLabs laufen über /v1/realtime; Text-to-Speech und Transkription über die Audio-Endpunkte. Realtime-Sitzungen werden nach Audio- und Text-Tokens je Modalität abgerechnet, Transkription sekundengenau, TTS pro Zeichen.
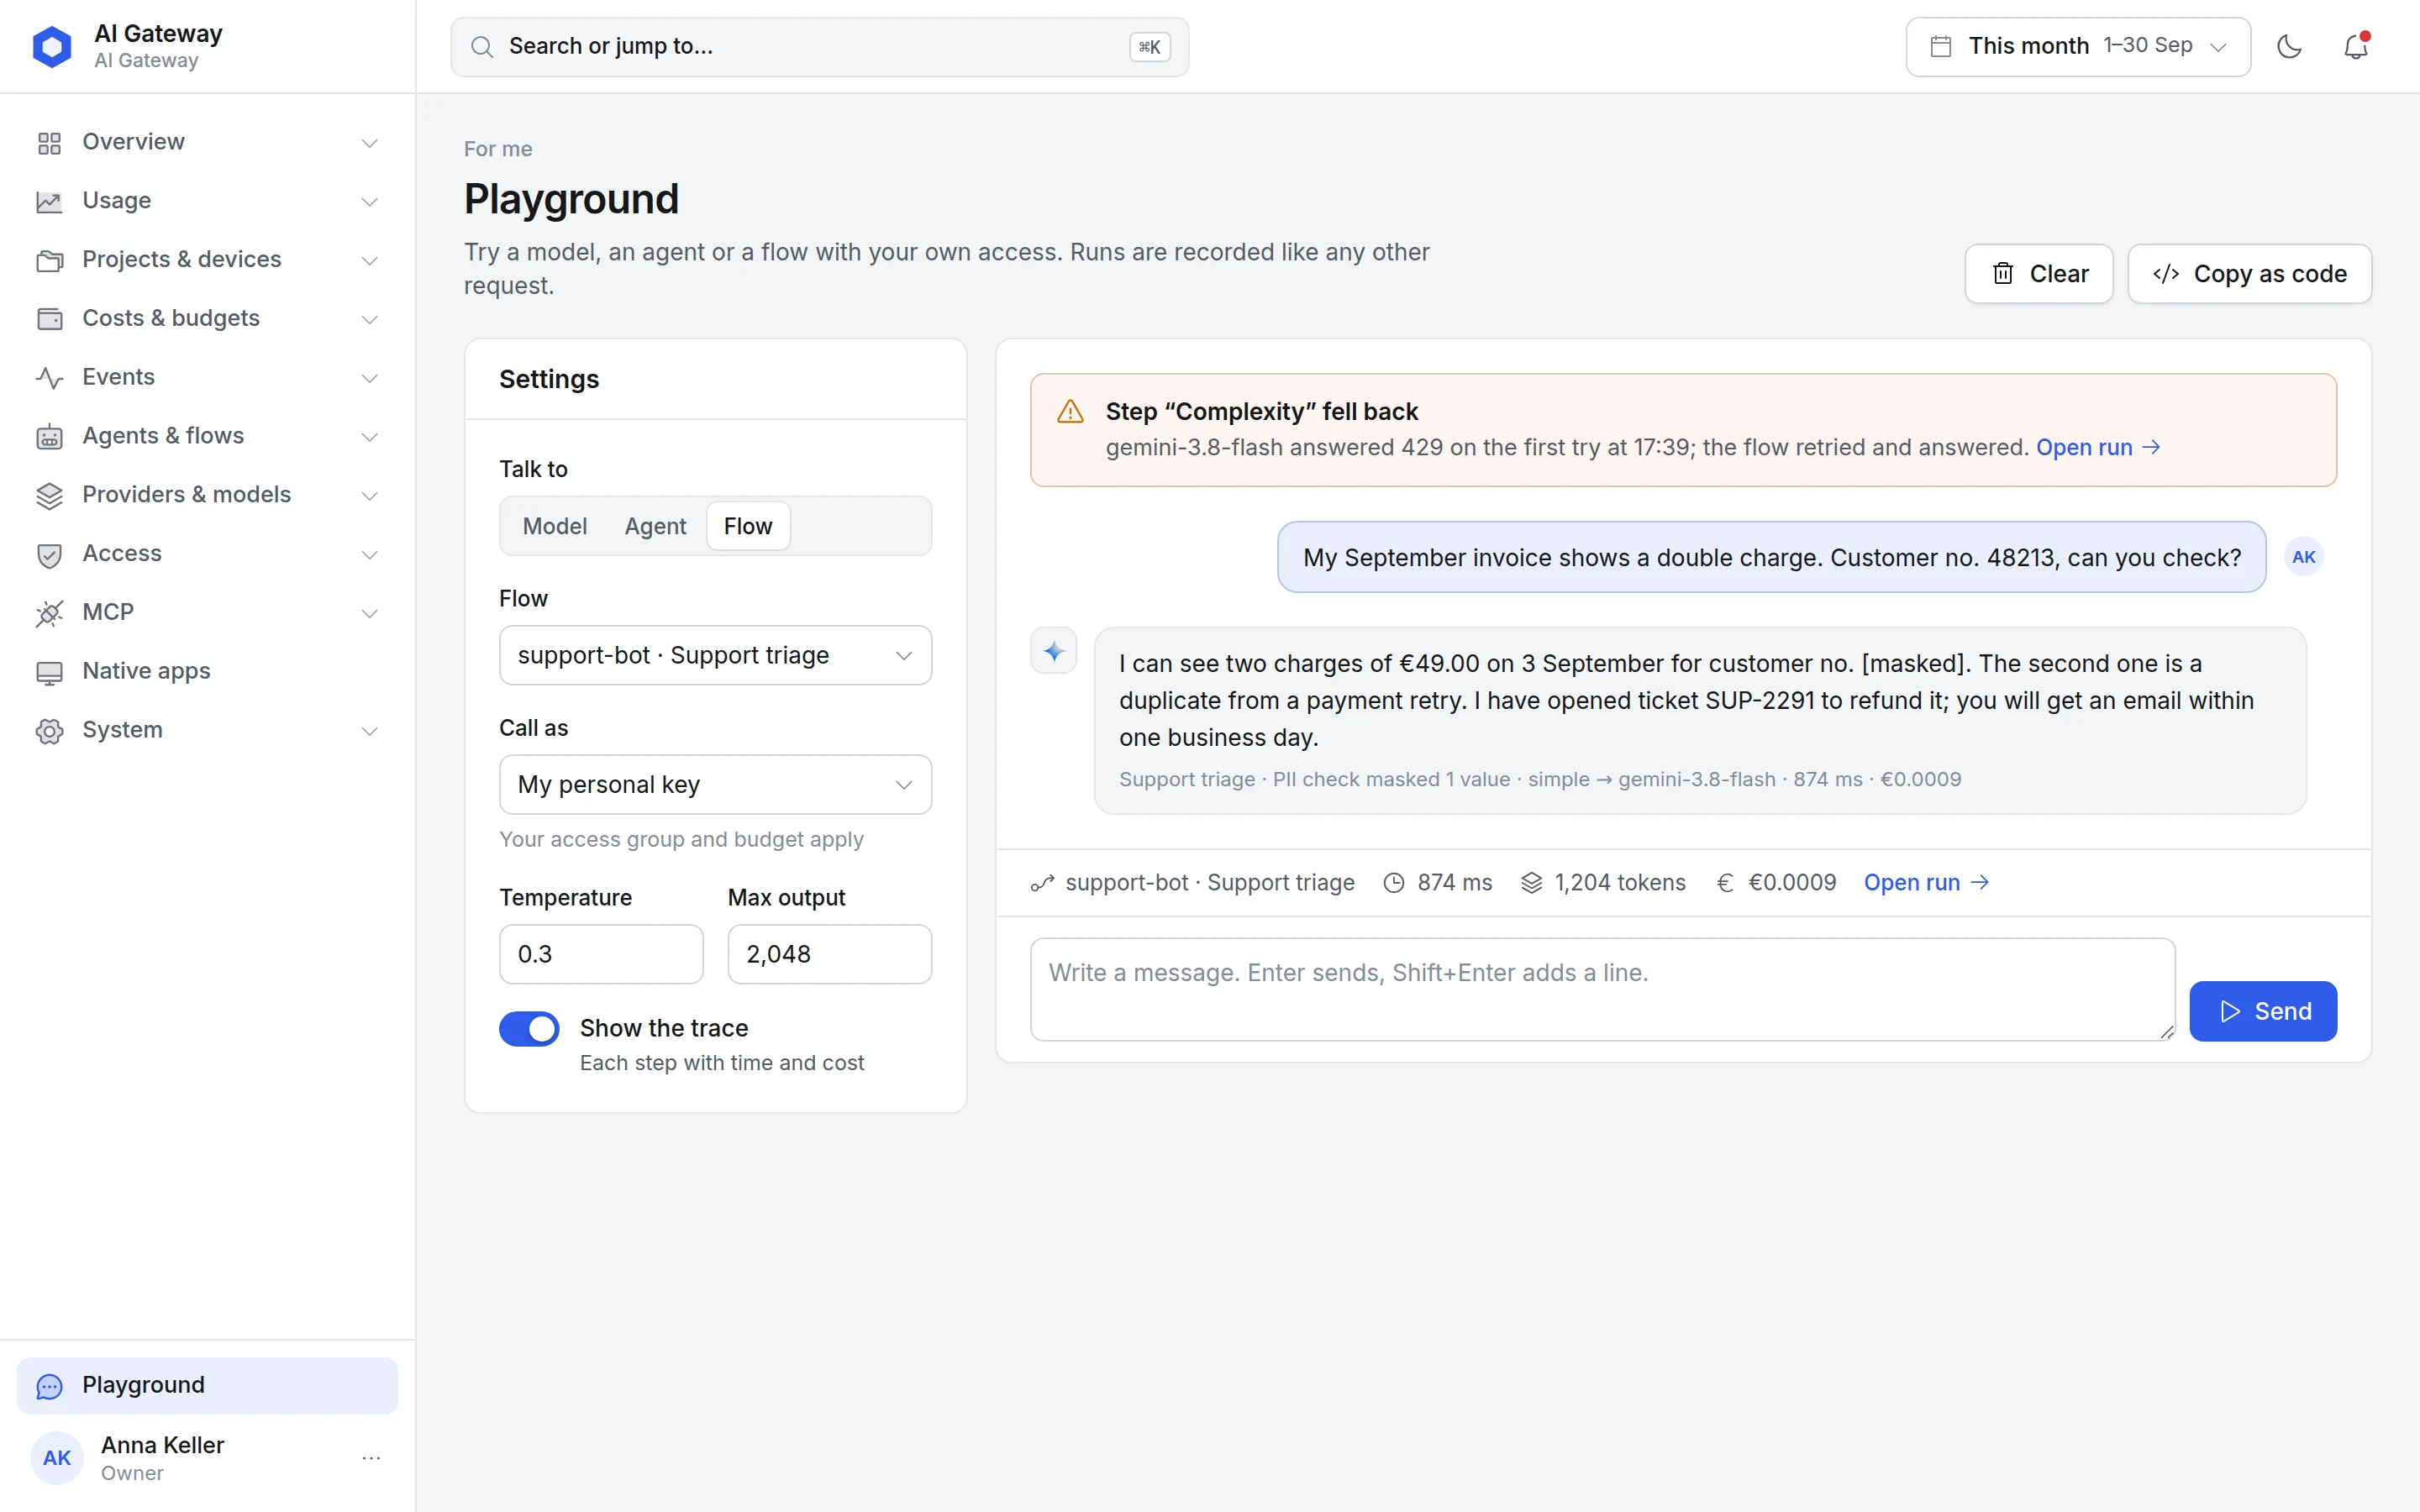
Eingebauter Playground - sofort testen
Probieren Sie jedes Modell, jeden Alias, jeden Flow und jedes MCP-Werkzeug direkt im Gateway aus - mit einem konkreten API-Key, sodass Berechtigungen, Budget und Kostenstelle exakt wie im Echtbetrieb greifen.
- Chat-, TTS- und Realtime-Modus in einer Oberfläche, Bildgenerierung als Basis-Modus
- MCP-Werkzeuge auflisten und aufrufen, System-Prompt und Parameter live einstellen
- Als
cURLexportieren und 1:1 in Ihre App übernehmen
Ihr Gateway in Ihrer Marke
Name, Logo und eine Farbe genügen: Das Gateway leitet daraus die komplette Oberfläche ab, von der Anmeldeseite bis zu den Diagrammfarben
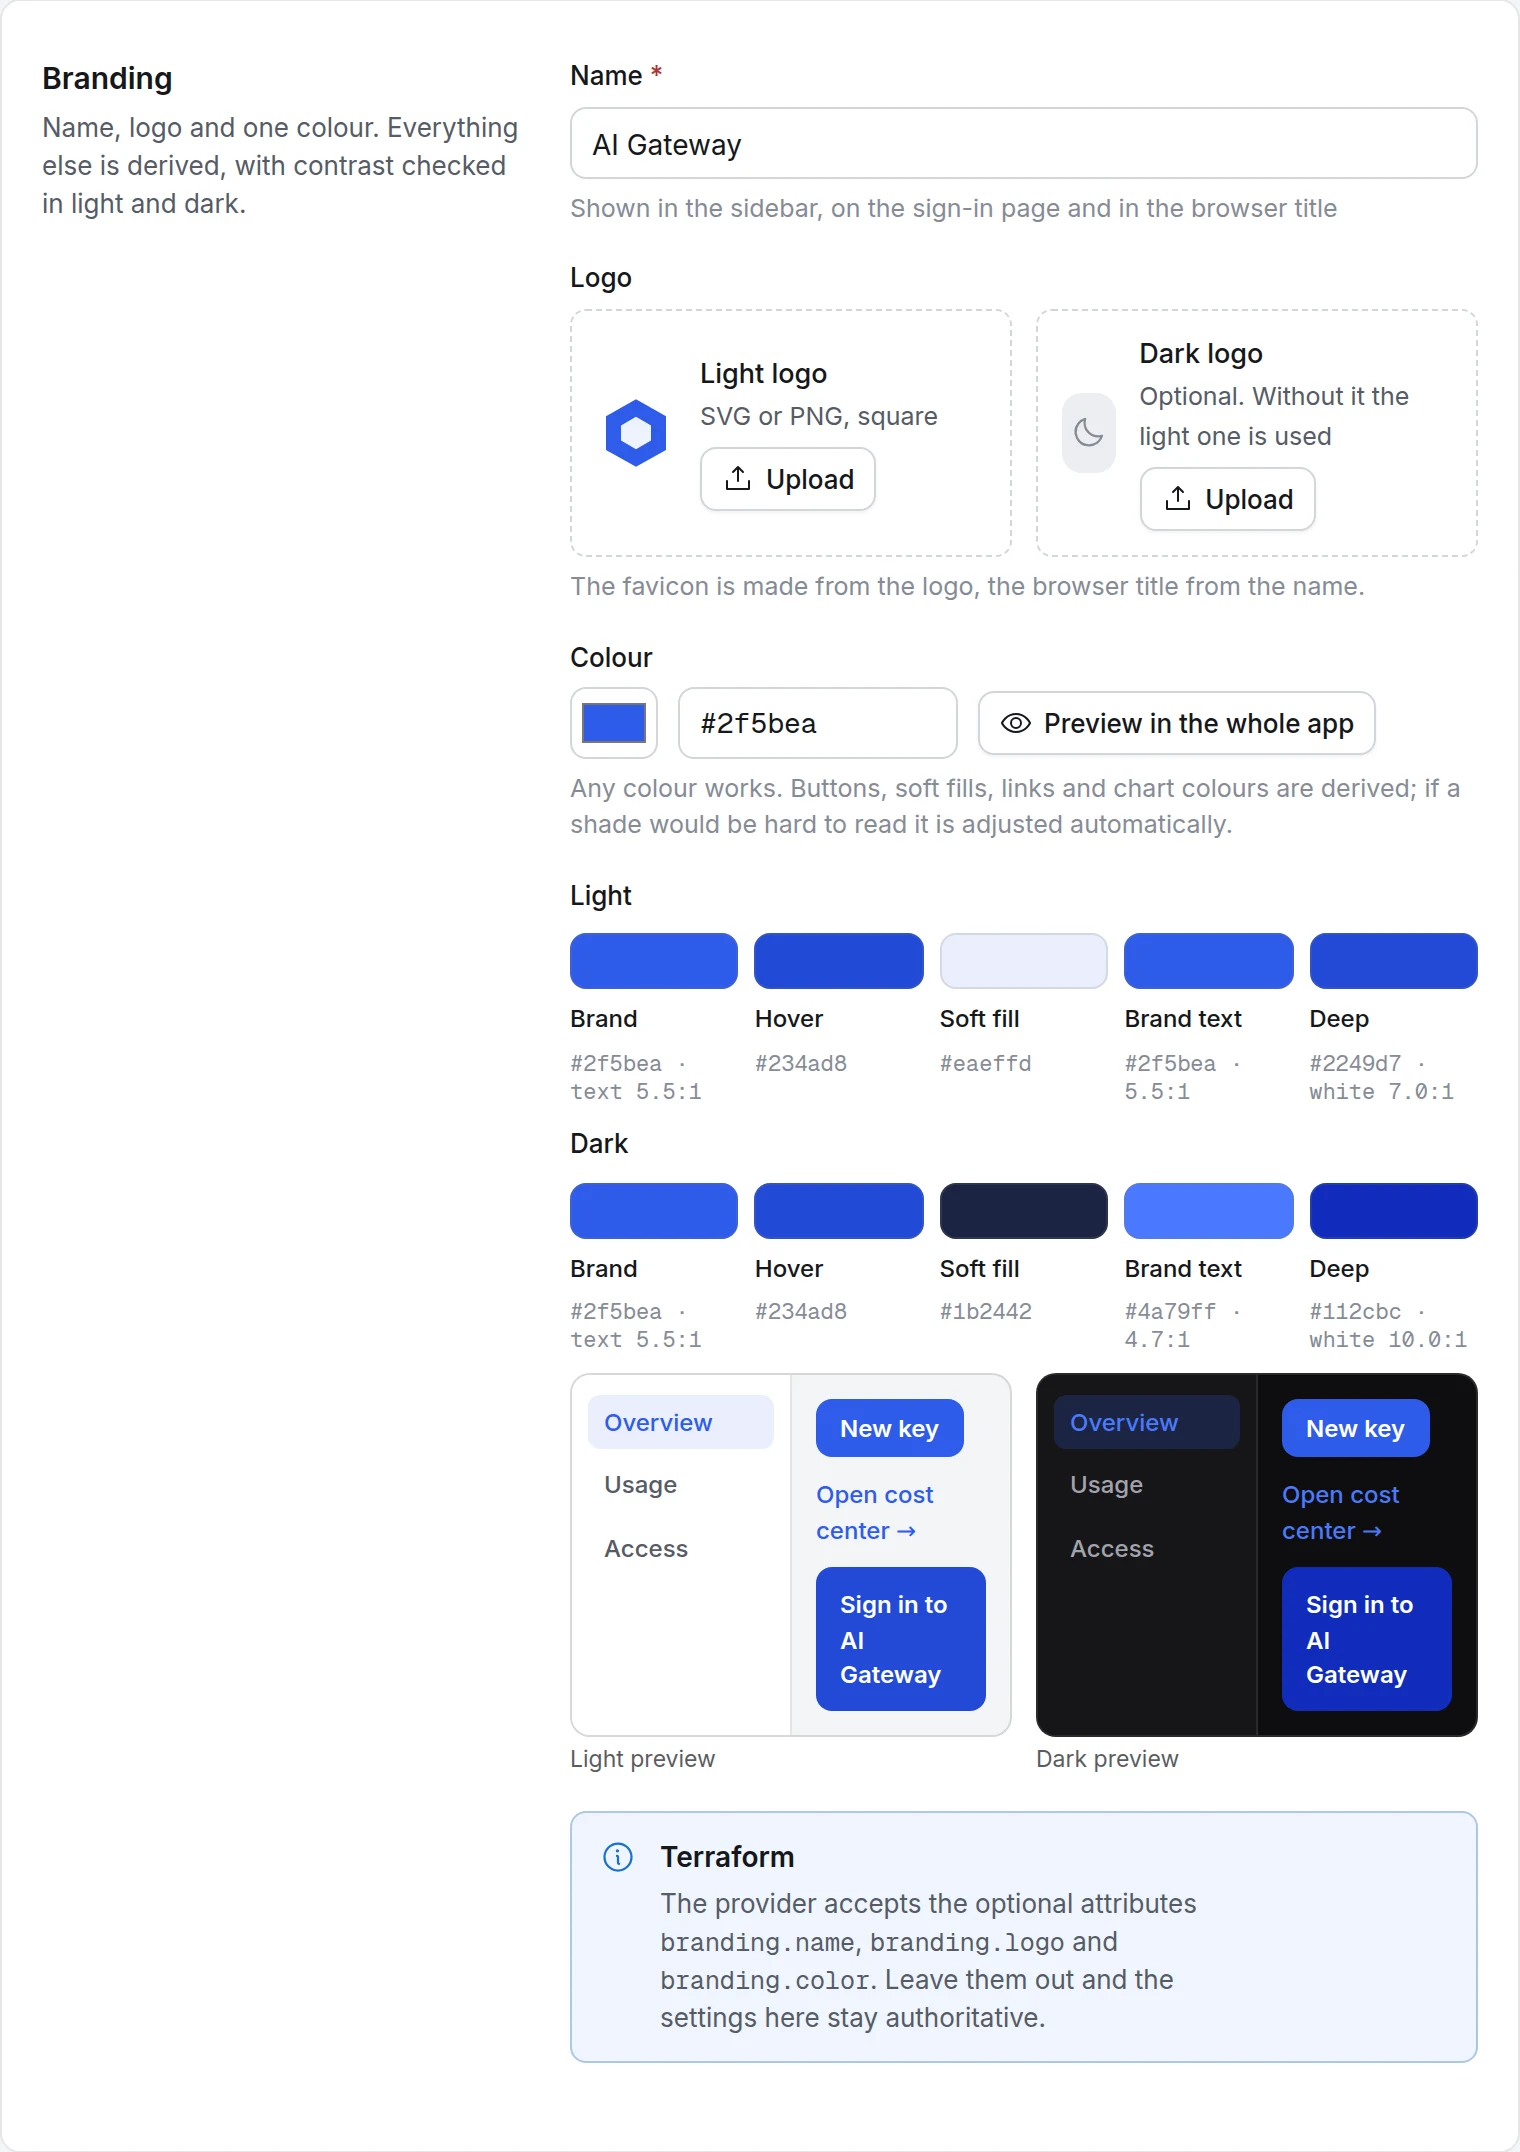
Branding in den Einstellungen, nicht im Code
Hinterlegen Sie den Namen Ihres Unternehmens, ein Logo (hell, optional dunkel) und eine Markenfarbe. Buttons, Flächen, Links und Diagrammfarben werden daraus abgeleitet; der Kontrast wird für Hell- und Dunkelmodus geprüft und, falls ein Ton schwer lesbar wäre, automatisch angepasst.
- Name in Sidebar, Anmeldeseite und Browsertitel, Favicon aus dem Logo
- Abgeleitete Palette mit Kontrastwerten und Vorschau für Hell und Dunkel
- Vorschau in der ganzen Oberfläche vor dem Speichern, Zurücksetzen auf den Standard jederzeit
- Auch per Terraform:
branding.name,branding.logo,branding.color
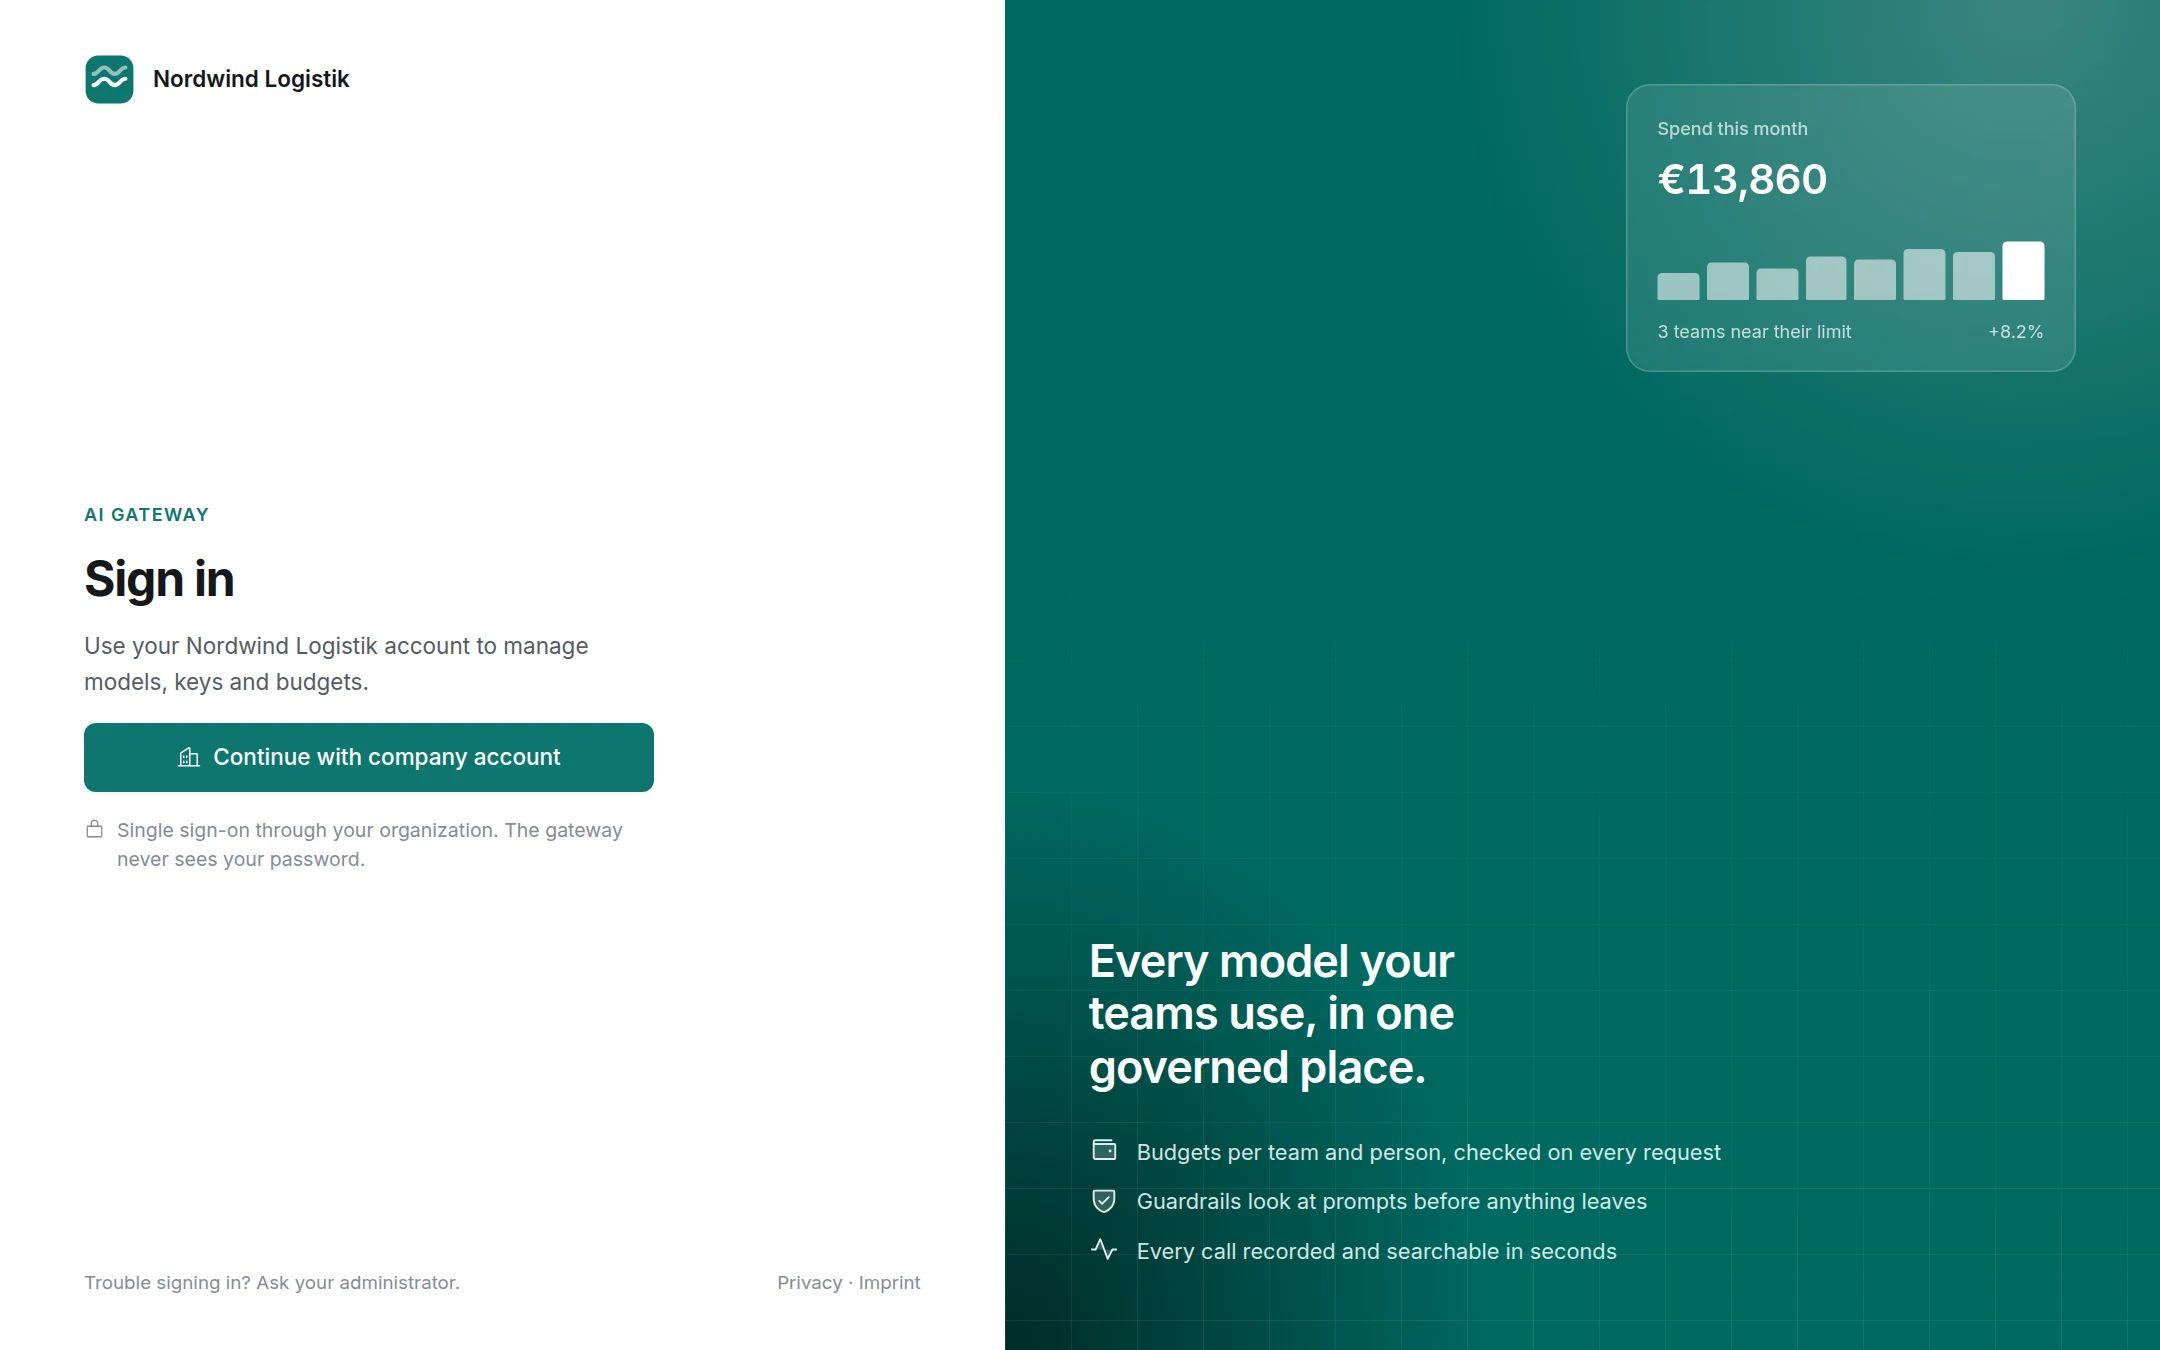
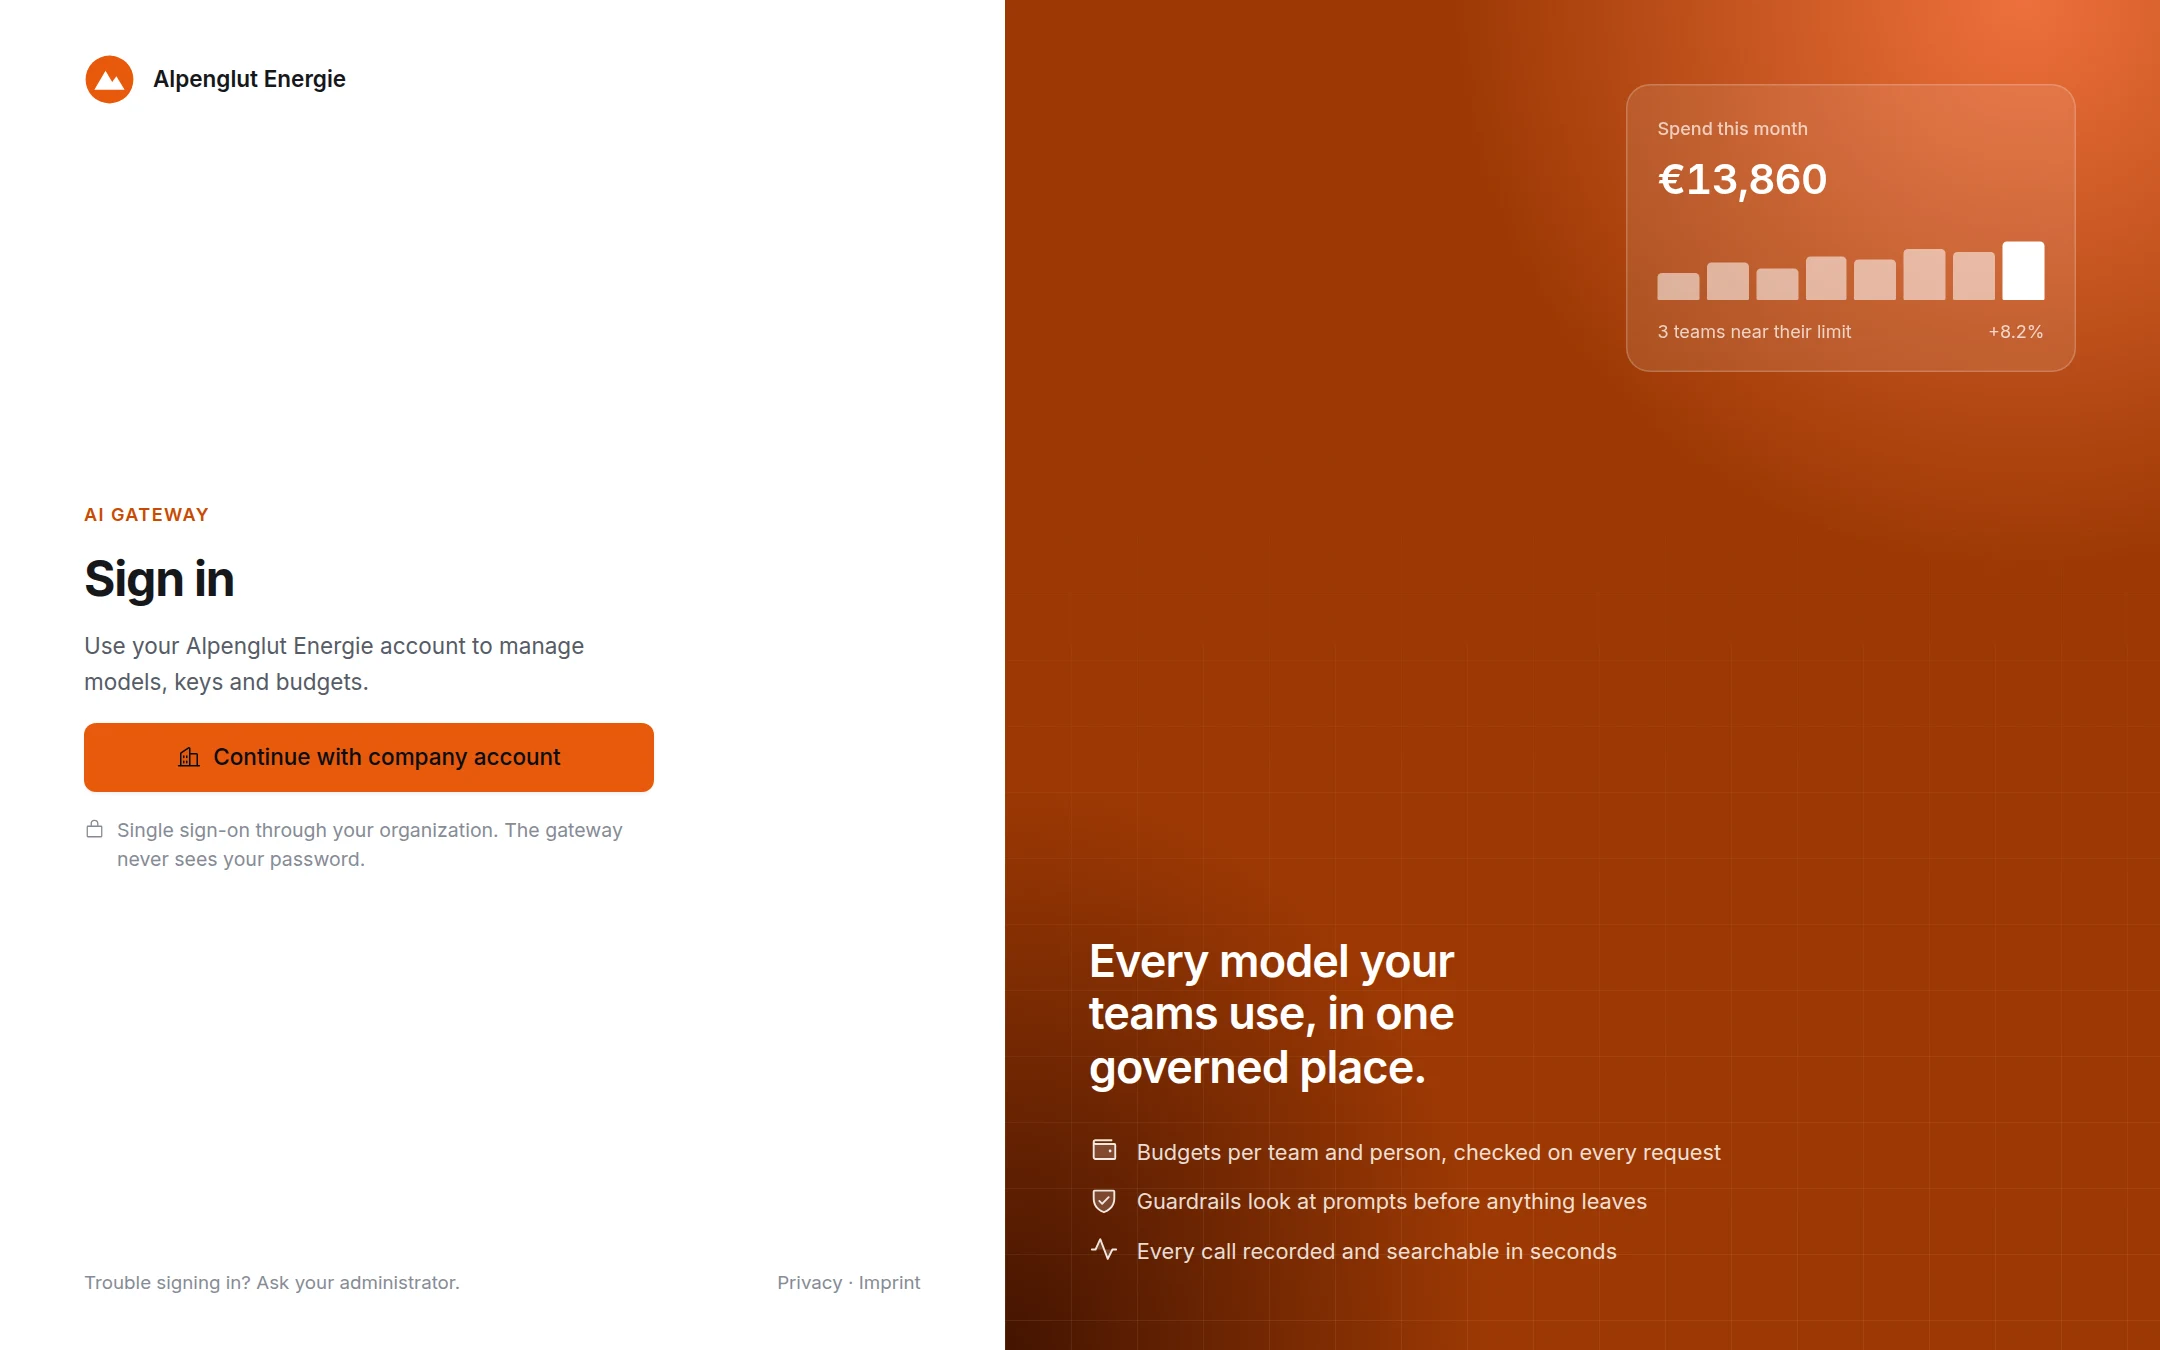
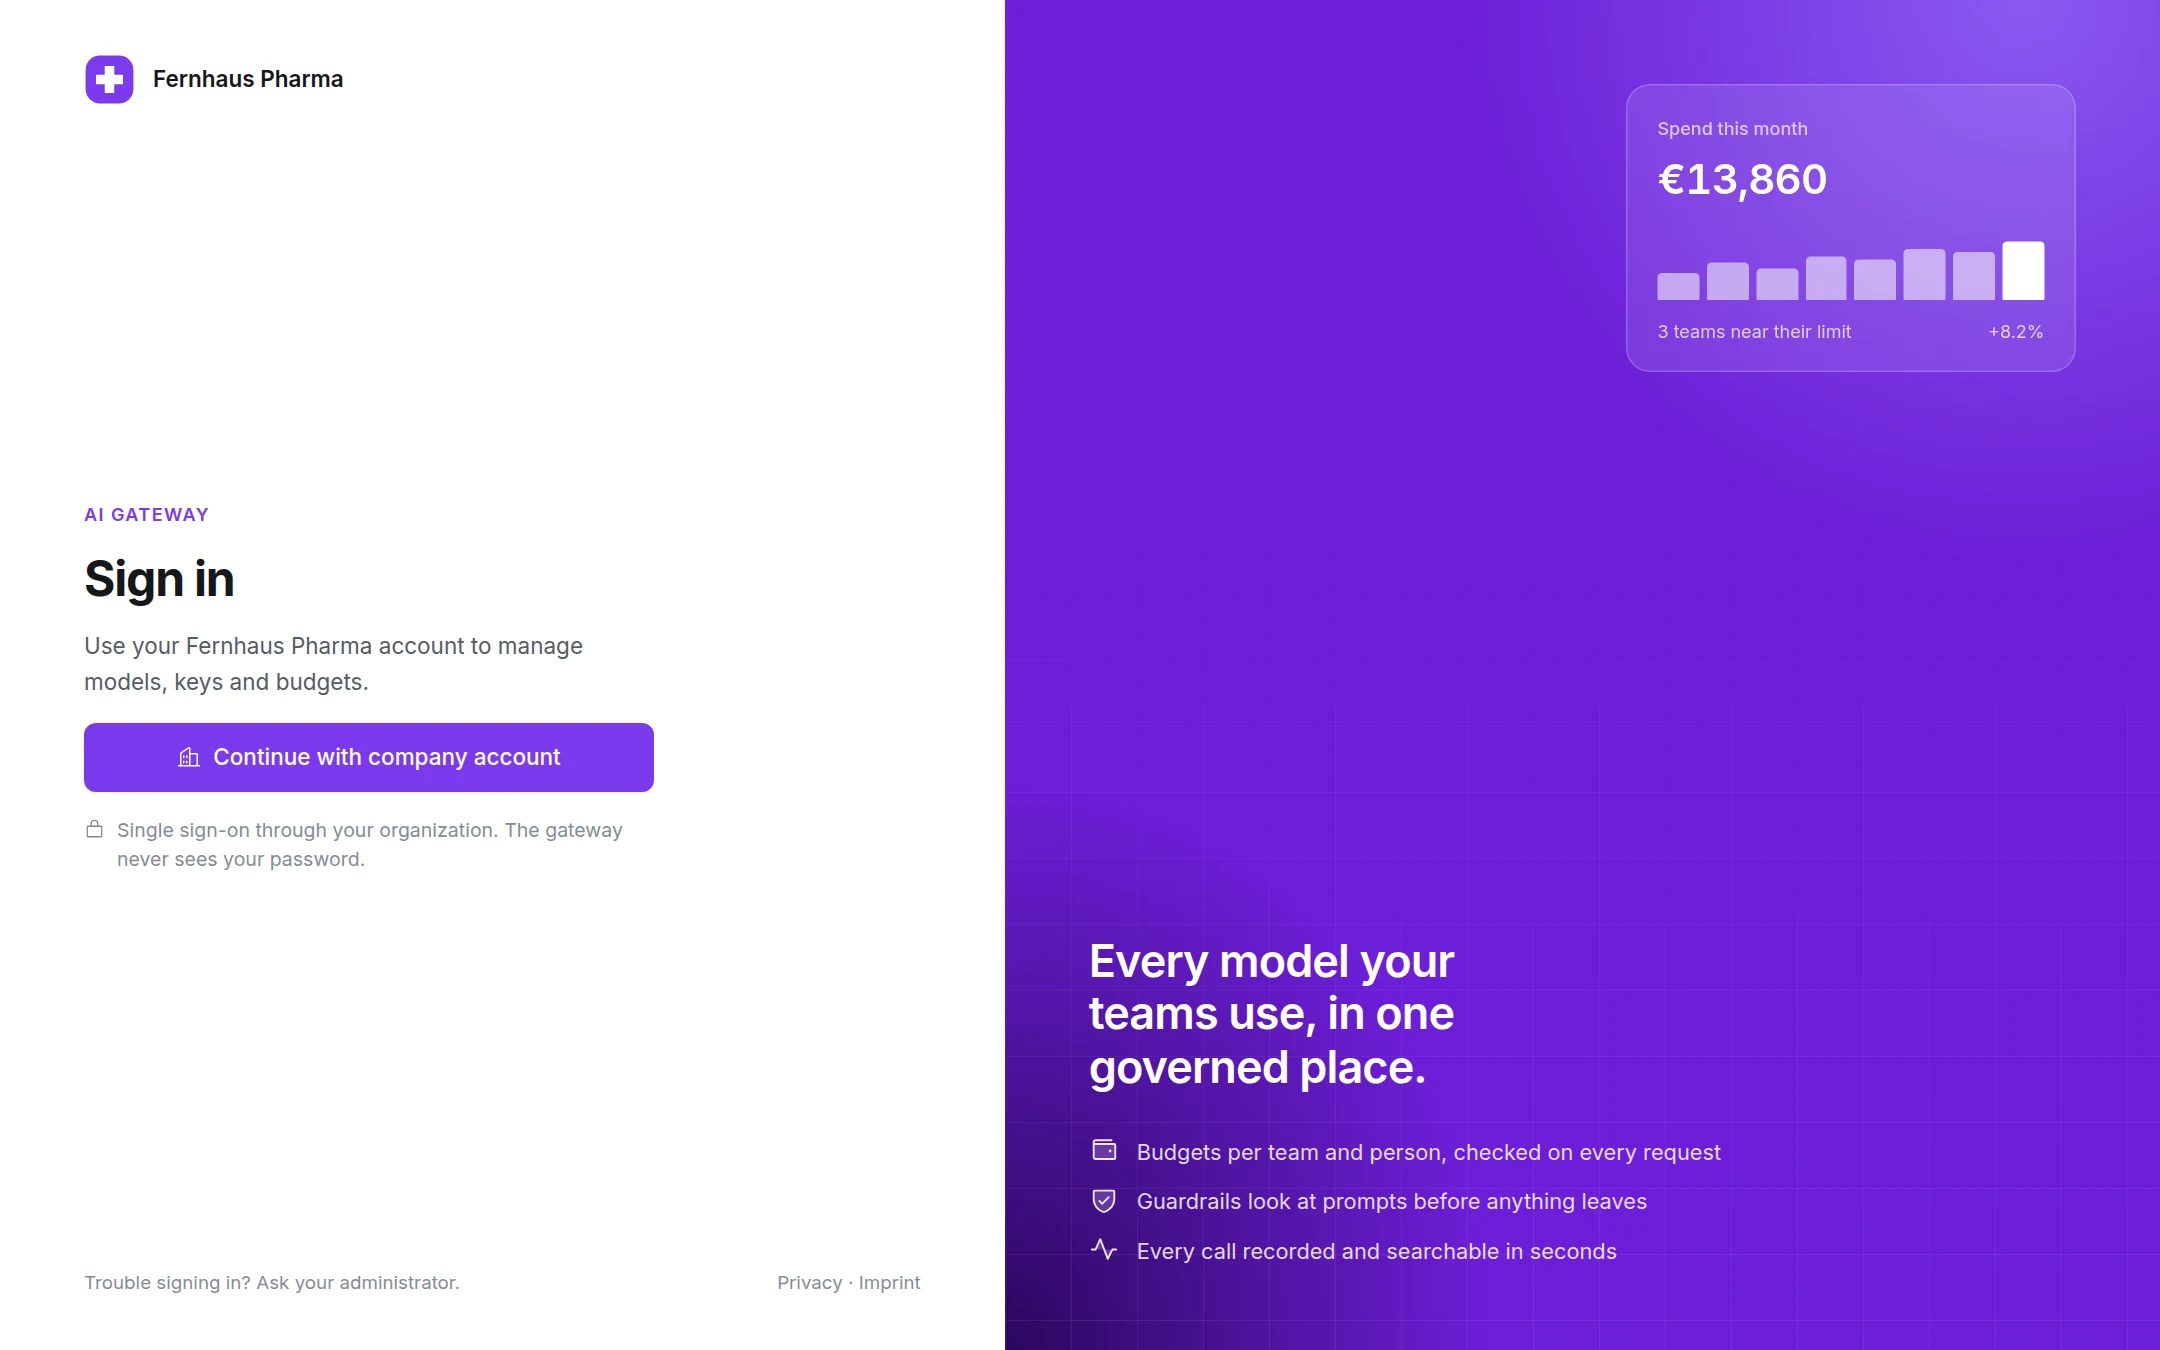
Dieselbe Anmeldeseite, drei fiktive Beispiel-Mandanten: Eine Farbe färbt Anmeldung, Navigation, Buttons und Diagramme. Die Anmeldung läuft per Single Sign-on über Ihr Unternehmenskonto; das Gateway sieht nie ein Passwort.
Betrieb & Integration
Eigenständig oder nativ in CompanyGPT - betrieben als Container in jeder Cloud
Eigenständiges Produkt
Setzen Sie das AI Gateway als zentrale Schaltstelle für alle KI-Zugriffe Ihrer Entwicklungsteams, CI/CD-Pipelines und Agenten ein - ganz ohne CompanyGPT. Eine URL, ein Key, volle FinOps-Transparenz.
Nativ in CompanyGPT integriert
Das Gateway ist nativ in unser CompanyGPT integriert: Kunden, die beides einsetzen, arbeiten nahtlos damit - dieselben Budgets, Kostenstellen und Guardrails für Chat, Agenten und Add-ons.
Läuft überall - einfach als Container
Sie sind nicht an einen Anbieter gebunden: Das Gateway wird als Docker-Container in Ihrer eigenen Umgebung betrieben, konfiguriert per YAML, Terraform-Provider oder in natürlicher Sprache.
Container (Docker)
Ein schlankes Backend-Image (ein Rust-Binary) plus ein Dashboard-Image, mit Prometheus-Metriken und Health-Endpunkten - schnell ausgerollt, mit Redis auf mehrere Replikas skaliert und überall lauffähig, wo Container laufen.
Datenbank
Speichert Konfiguration und Nutzungsdaten in PostgreSQL, MongoDB oder Azure Cosmos DB - Sie wählen, was zu Ihrer Cloud passt. PostgreSQL ist der souveräne Pfad, etwa mit STACKIT PostgreSQL Flex.
Identity / SSO
Anbindung an Ihren Identity-Provider: Microsoft Entra ID, Keycloak oder AWS Cognito per OIDC - rollenbasiert, mit Gruppen-Mapping für sechs Rollen; Gast wird automatisch für Logins außerhalb Ihrer Domains vergeben.
Jede Cloud
Läuft als Container überall - Referenzpfade für Microsoft Azure (Container Apps, AKS) und STACKIT, weitere Clouds über Kubernetes. In der Region Ihrer Wahl, auch DSGVO-konform und souverän in Deutschland.
Wir helfen beim Rollout in Ihrer Cloud
Gemeinsam mit der innFactory GmbH - offizieller Microsoft Cloud Solution Provider (CSP) - richten wir das Gateway in Ihrer Umgebung ein. Kein eigenes Cloud-Konto? Wir liefern die passende Azure Subscription für Ihr Unternehmen - inklusive Abrechnung, Support und optionaler Wartung.
Lizenzkosten
Monatliche Lizenz, gestaffelt nach Nutzerzahl - Betrieb in Ihrer Infrastruktur, Token-Kosten direkt bei Ihren Providern
10 % Rabatt auf die Lizenz, wenn Sie Ihre KI-Modelle über das Reselling der innFactory GmbH beziehen | Alle Preise zzgl. 19 % USt.
AI Gateway im Vergleich: Proxy, Marktplatz oder Governance-Schicht?
Routing und Modell-Zugriff können viele Werkzeuge. Worauf es im Unternehmen ankommt, ist die Kontroll-, Governance- und FinOps-Schicht darüber - genau hier setzt das AI Gateway an.
| Worauf es im Unternehmen ankommt | Typischer Proxy oder Marktplatz | innFactory AI Gateway |
|---|---|---|
| Agent-Zeit von Coding-Agenten messen - auch für Nutzung im Abo, die nie durch den Proxy läuft | nur, was durch den Proxy läuft | ✓ Companion auf dem Entwickler-Rechner |
| Ein Kontrollpunkt vor allen KI-Tools - Claude Code, Codex, OpenCode, Cowork, VS Code & eigene Apps | pro Tool selbst verdrahten | ✓ fertige Setups, ein Befehl |
| Kosten je Kunde, Projekt & Kostenstelle in Euro abrechnen und weiterberechnen | meist in US-Dollar, ohne Marge | ✓ Kostenstellen, Kundenpreise, EZB-Kurs |
| Zugriff & Identität je Mitarbeiter (SSO, rollenbasiert, sieben Rollen) | je nach Produkt und Tarif | ✓ Entra ID / Keycloak / OIDC in jeder Lizenz |
| Abläufe ohne Zusatz-Infrastruktur - Modelle, Guardrails und Webhooks verketten | Routing-Regeln, externe Workflow-Tools | ✓ Flow Builder im Gateway |
| Betrieb, Support & Verantwortung in der EU | Self-Hosted / DIY oder US-Cloud | ✓ Managed aus Deutschland + Rollout |
Die linke Spalte beschreibt die Kategorie, nicht ein einzelnes Produkt. Zur Einordnung, jeweils laut Anbieter-Dokumentation mit Stand 26.09.2026: Bei LiteLLM ist Single Sign-on ab dem sechsten Nutzer sowie JWT/OIDC-Authentifizierung für API-Anfragen Teil der Enterprise-Lizenz, bis fünf Nutzer kostenfrei. LiteLLM, OpenRouter, Portkey und Cloudflare AI Gateway erfassen Anfragen, Tokens und Kosten, die über das jeweilige Gateway laufen; ein lokaler Companion für die Agent-Zeit von Coding-Agenten ist in keiner der vier Dokumentationen beschrieben. Cloudflare AI Gateway bietet einen visuellen Editor für dynamisches Routing mit Bedingungs-, Modell- und Limit-Knoten; Guardrail- und Webhook-Knoten sind dort nicht dokumentiert. Belegte Gegenüberstellungen mit einzelnen Anbietern folgen weiter unten.
Belegte Gegenüberstellungen mit anderen LLM-Gateways
Jeweils laut Dokumentation des Anbieters, mit Stand-Datum und Quellen
Open-Source-Gateways selbst betreiben
Gehostete Gateways und Marktplätze
KI-Plattformen mit Gateway-Modul
AI Gateway für Ihr Unternehmen
Was Sie bekommen:
- Eine API in drei Dialekten (OpenAI, Anthropic, Gemini) für dreizehn Provider-Typen
- Proxy-Modus mit fertigen Setups für Claude Code, Codex, OpenCode, Cowork und VS Code
- Companion-Modus für Agent-Zeit und LLM-Zeit - auch im Abo
- AI-FinOps: Kostenstellen, Per-Member-Caps, Repository-Regeln, Insights, CSV-Export
- Budgets für Organisation, Kostenstelle, Nutzer und Key, Per-Model-Caps, TPM-Limits
- Flow Builder, MCP-Proxy, Guardrails mit Schattenmodus, Audit-Log
- Sieben Rollen aus Entra ID, Keycloak oder OIDC - in jeder Lizenz
- Preise in Euro auf Basis von ai-prices.eu, eigenständig oder in CompanyGPT
AI Gateway lizenzieren
pro Monat
Gestaffelt nach Nutzerzahl, bis 749 EUR/Monat ab 1.000 Nutzern.
10 % Rabatt bei Modellbezug über das Reselling der innFactory GmbH. Alle Preise zzgl. USt.
Demo anfragenHäufige Fragen
Alles Wichtige zu Proxy-Modus, Companion, AI-FinOps und Betrieb
Was ist ein AI Gateway?
Ein AI Gateway ist ein zentraler Proxy zwischen Ihren Anwendungen, Coding-Tools und KI-Agenten und den KI-Providern (OpenAI, Anthropic, Google u. a.). Es bündelt alle KI-Zugriffe hinter einer API in OpenAI-, Anthropic- oder Gemini-Dialekt und übernimmt Authentifizierung, Routing, Budgets, Guardrails und Kostenabrechnung. Für Unternehmen ist es die zentrale Security-, Governance- und FinOps-Schicht für KI.
Was ist der Unterschied zwischen Proxy-Modus und Companion-Modus?
Im Proxy-Modus laufen die KI-Anfragen Ihrer Tools durch das Gateway: Es prüft Budget und Rechte, wählt den Provider und rechnet jeden Token ab. Im Companion-Modus läuft ein kleiner Dienst (aigw) auf dem Rechner der Entwicklerin oder des Entwicklers und misst, wie lange Claude Code, Codex und OpenCode tatsächlich arbeiten, auch wenn die Tools über ein Abo laufen und das Gateway nie berühren. Beide Modi lassen sich kombinieren: Der Companion startet die Tools auf Wunsch direkt mit einem kurzlebigen Gateway-Token.
Wie misst das Gateway Agent-Zeit und LLM-Zeit?
Agent-Zeit ist die Zeit, in der ein Coding-Agent aktiv für eine Person arbeitet, berechnet aus den Ereignissen der Sitzung; unbeaufsichtigte Läufe zählen vollständig. LLM-Zeit ist die reine Dauer der Modellaufrufe. Beide Werte werden getrennt ausgewiesen, pro Repository, Nutzer, Tool und Kostenstelle. Der Companion liest dafür nur die lokalen Sitzungsprotokolle der Tools und lädt eine feste Allow-List hoch: keine Prompts, keine absoluten Pfade, keine Zugangsdaten.
Erfasst das Gateway auch Nutzung über Abos wie Claude Max oder ChatGPT?
Ja. Der Companion erkennt, ob eine Sitzung über das Gateway lief oder über ein Abo des Tools. Abo-Nutzung wird als Companion-Tokens getrennt ausgewiesen und zur Information mit dem Listenpreis aus ai-prices.eu bewertet. Sie wird nie abgerechnet, budgetiert oder gegen Limits gerechnet, damit Abo und Gateway-Verbrauch in Insights nie vermischt werden.
Welche Coding-Tools lassen sich anbinden?
Fertige Setups gibt es für Claude Code, Codex, OpenCode, Cowork (Claude Desktop) sowie VS Code mit Continue oder GitHub Copilot. Der Befehl aigw run startet Claude Code, Codex und OpenCode mit einem kurzlebigen Proxy-Token, ohne die Konfiguration des Tools zu verändern. Andere Harnesses wie Pi oder Gemini CLI nutzen den OpenAI-kompatiblen Endpunkt des Gateways, allerdings ohne Agent-Zeit-Messung durch den Companion.
Funktioniert Claude Desktop mit dem Gateway?
Cowork, der Agent in Claude Desktop, erhält ein verwaltetes Profil für macOS (Konfigurationsprofil) und Windows (Registrierung), das die Gateway-Adresse und das Auth-Schema setzt. Außerdem ist Claude Desktop als MCP-Client anbindbar: Über den eingebauten MCP-Server gateway-config lässt sich das Gateway direkt aus dem Chat heraus in natürlicher Sprache konfigurieren. Das klassische Chat-Fenster von Claude Desktop lässt sich nicht über ein Gateway proxyen, weil es keine eigene Basis-URL anbietet.
Wann braucht ein Unternehmen ein AI Gateway?
Sobald mehr als ein Team, mehrere Tools oder autonome KI-Agenten KI nutzen. Dann fehlen ohne zentrale Schicht Kostenkontrolle, Zuordnung und Governance. Ein AI Gateway verhindert Schatten-KI, Budgetüberschreitungen und Compliance-Risiken und macht KI-Kosten pro Team, Nutzer, Agent und Kunde nachvollziehbar.
Was kostet das AI Gateway?
Die Lizenz ist monatlich nach Nutzerzahl gestaffelt: 199 EUR bis 10 Nutzer, 299 EUR bis 50, 399 EUR bis 150, 499 EUR bis 500, 599 EUR bis 1.000 und 749 EUR ab 1.000 Nutzern (zzgl. USt.). Beim Modellbezug über das Reselling der innFactory GmbH gibt es 10 % Rabatt auf die Lizenz. Token-Kosten rechnen Sie direkt mit Ihren Providern ab.
Wie unterscheidet sich das Gateway von LiteLLM, OpenRouter, Portkey oder Cloudflare AI Gateway?
LiteLLM (Open-Source-Proxy), OpenRouter (gehosteter Modell-Marktplatz), Portkey (laut eigener Website seit Juli 2026 als PRISMA AIRS AI Gateway von Palo Alto Networks positioniert, Stand 26.09.2026) und Cloudflare AI Gateway lösen Routing und Modellzugriff. Das innFactory AI Gateway ergänzt die Governance- und FinOps-Schicht darüber: Nutzer-Scoping über Entra ID oder Keycloak, Kostenstellen mit Per-Member-Caps, Agent-Zeit-Messung per Companion auch für Abo-Nutzung, Flow Builder, Preise in Euro aus ai-prices.eu, betrieben in Ihrer Cloud oder in deutschen Rechenzentren. Ausgewogene Gegenüberstellungen mit Stand und Quellen finden Sie auf unseren Vergleichsseiten.
Brauche ich CompanyGPT, um das Gateway zu nutzen?
Nein. Das AI Gateway ist ein eigenständiges Produkt für alle KI-Zugriffe Ihrer Tools, Pipelines und Agenten. Wenn Sie bereits CompanyGPT nutzen, dient das Gateway als gemeinsame Kostenkontroll-Schicht für Chat, Agenten und Add-ons.
Welche Provider und Modelle werden unterstützt?
Dreizehn Provider-Typen: OpenAI, Azure OpenAI, Azure AI Foundry, Anthropic Claude (direkt oder über Vertex AI), Google Gemini (AI Studio oder Vertex AI inklusive EU-Endpunkt), Mistral, AWS Bedrock (inklusive Bedrock Mantle), STACKIT, IONOS, Ollama, LM Studio, ElevenLabs sowie eigene OpenAI-kompatible Endpunkte. Modelle werden automatisch eingelesen, Preise stammen aus ai-prices.eu und werden vor der Übernahme von einem Admin freigegeben. Neue Modellversionen ordnen die Adapter über Modellfamilie und Version zu, nicht über feste Listen.
Kann das Gateway Anfragen automatisch an das passende Modell routen?
Ja. Ein Auto-Router bewertet die Komplexität jedes Prompts und wählt eine Stufe (einfach, mittel, komplex, Reasoning) aus den Modellen, die der jeweilige Nutzer laut Access Group nutzen darf, nie ein verbotenes Modell. Dazu kommen Aliase, Fallback-Modelle über Provider hinweg, ein Budget-Fallback-Modell statt harter Ablehnung und ein optionaler Response-Cache. Jede Routing-Entscheidung wird mit Begründung protokolliert.
Was ist der Flow Builder?
Der Flow Builder ist ein visueller Editor im Gateway, mit dem Sie Modelle, Guardrails, Router und Webhooks zu wiederverwendbaren Abläufen verketten. Strategien wie Failover, Least Cost, Least Latency oder Cost Cascade, Guardrail-Knoten als Inhalts-Router und Ereignis-Trigger (etwa ein überschrittenes Budget) sind eingebaut. Ein Flow lässt sich wie ein Modell aufrufen und bucht auf dieselben Kostenstellen und Budgets. Auf Tablets gibt es eine touch-fähige Leinwand, auf dem Smartphone einen YAML-Editor.
Wie erkenne ich die Kosten einer einzelnen Anfrage?
Jede gepufferte Antwort trägt den Header x-aigateway-response-cost mit dem abgerechneten Betrag in USD, dazu Budget-Header für Organisation, Nutzer, Kostenstelle und Key. In Insights sehen Sie Verbrauch und Kosten pro Nutzer, Kostenstelle, Modell, Tool und Repository in Euro, umgerechnet mit dem EZB-Tageskurs, inklusive Budget-Auslastung und CSV-Export.
Unterstützt das Gateway Sprach- und Realtime-Modelle?
Ja. Über /v1/realtime laufen OpenAI Realtime, Azure OpenAI, Gemini Live (auch über den Vertex-EU-Endpunkt) und ElevenLabs; Text-to-Speech und Transkription werden über die OpenAI-kompatiblen Audio-Endpunkte bedient. Realtime-Sitzungen werden nach Audio- und Text-Tokens je Modalität abgerechnet, Transkription sekundengenau und TTS pro Zeichen, damit Voice-Sitzungen korrekt auf Budgets angerechnet werden.
Wo werden meine Daten verarbeitet?
Das Gateway läuft als Container in Ihrer Cloud oder in souveränen deutschen Rechenzentren (STACKIT), mit PostgreSQL, MongoDB oder Azure Cosmos DB als Datenbank. Prompts und Daten bleiben unter Ihrer Kontrolle. API-Keys werden nur als Hash gespeichert, Provider-Zugangsdaten AES-256-GCM-verschlüsselt mit rotierbaren Schlüsseln. Die Erfassung von Prompt-Inhalten für die Observability ist standardmäßig aus.
Was bedeutet AI-FinOps konkret?
AI-FinOps überträgt die FinOps-Praxis auf KI-Kosten: messen, zuordnen, budgetieren, optimieren. Die FinOps Foundation beschreibt das als FinOps for AI, mit Kennzahlen wie Kosten pro Token und Quoten pro Team. Im Gateway bedeutet das: Kostenstellen mit Pool- oder Per-User-Modus, Budgets für Organisation, Nutzer und Key, Per-Model-Caps, TPM-Limits und Insights, die jeden Token einem Team, Nutzer, Repository oder Kunden zuordnen.
Kann ich das AI Gateway mit meinem eigenen Branding betreiben?
Ja. In den Einstellungen hinterlegen Sie den Namen Ihres Unternehmens, ein Logo (hell, optional dunkel) und eine Markenfarbe. Das Gateway leitet daraus Buttons, Flächen, Links und Diagrammfarben ab und prüft den Kontrast für Hell- und Dunkelmodus automatisch. Der Name erscheint in der Sidebar, auf der Anmeldeseite und im Browsertitel, das Favicon entsteht aus dem Logo. Dieselben Werte lassen sich über den Terraform-Provider setzen.
Gibt es deutsche Alternativen zum AI Gateway?
Ja, etwa TokenControl von white duck aus Rosenheim, das sich laut Anbieter auf FinOps und Governance für KI-Anwendungen konzentriert. Das innFactory AI Gateway setzt zusätzlich auf den Companion für Agent-Zeit, den Flow Builder, den MCP-Proxy und die native Anbindung von Coding-Tools. Welche Lösung passt, hängt vom Einsatz ab; wir beraten Sie gern neutral.
Bereit für KI-Kostenkontrolle?
Vereinbaren Sie ein Gespräch und erfahren Sie, wie das AI Gateway Ihre KI-Kosten transparent und steuerbar macht - für Tools, Agenten und Abos.